笔记:Risk assessment for modern industry
Risk assessment for modern industry
作者背景:本文由 Luca Pinciroli、Seyed Ali Hosseini、Mei Chen、Maria Valentina Clavijo Mesa、Thomas Matteo Coscia、Juan-Pablo Futalef、Stefano Marchetti、Leonardo Miqueles、Santiago Taguado Menza 和 Enrico Zio 合作撰写。作者主要来自意大利米兰理工大学(Politecnico di Milano)能源系;通讯作者 Enrico Zio 同时隶属于法国 Mines Paris–PSL University 的风险与危机研究中心(CRC)。从文中列出的研究项目、作者贡献和所介绍的案例看,团队的工作涵盖工业可靠性与风险评估、系统韧性、随机仿真、关键基础设施、数字孪生及气候变化风险。
Abstraction
Modern industry is undergoing rapid transformation driven by various factors and challenges like digitalization, climate change and systems interdependencies, necessitating a paradigm shift in risk assessment. Traditional methods, often static and siloed, struggle to address dynamic risks such as aging infrastructures, cyber-physical interdependencies and climate-induced hazards. This paper explores cutting-edge approaches to dynamic, data-driven risk assessment, integrating advanced simulation, artificial intelligence and real-time monitoring to enhance reliability and resilience in industrial systems, and shares some reflections and studies on them with the purpose of stimulating further development. Through case studies spanning manufacturing, energy and critical infrastructures, we demonstrate how modern methodologies, from digital twins to probabilistic climate impact models, enable proactive risk management. Key themes include: i) the role of real-time adaptability of safety-critical systems, ii) computational advances for rare-event and cascading-risk analysis, and iii) the integration of environmental stressors into long-term risk analysis frameworks. We conclude with an analysis of possible research directions to bridge gaps between technology, regulation and scalability, offering a roadmap for next-generation risk assessment methods.
摘要翻译:现代工业正在经历快速变革,其驱动因素和挑战包括数字化、气候变化以及系统之间不断增强的相互依赖关系,这些变化要求风险评估发生范式转变。传统方法通常具有静态性和领域分割特征,难以应对基础设施老化、信息物理系统依赖关系以及气候引发的危险等动态风险。本文探讨动态、数据驱动风险评估的前沿方法,研究如何结合先进仿真、人工智能和实时监测来提高工业系统的可靠性与韧性,并通过相关思考和研究实例促进这些方法的进一步发展。论文通过制造业、能源和关键基础设施等领域的案例,展示从数字孪生到概率气候影响模型等现代方法如何支持主动风险管理。重点主题包括:①安全关键系统的实时适应能力;②罕见事件与级联风险分析的计算方法进展;③将环境应力因素纳入长期风险分析框架。最后,论文分析了弥合技术、监管与可扩展性之间差距的潜在研究方向,为下一代风险评估方法提供发展路线。
1. Introduction
从工业4.0向正在兴起的工业5.0过渡,标志着一次重要的范式转变:工业系统正在从强调自动化和数据交换,转向更加以人为中心、更可持续、更重视协作的生态系统。工业5.0设想人工智能(AI)、机器学习(ML)、机器人技术和实时分析等先进技术不再只是实现自动化的工具,而是能够以符合伦理、可持续且具有韧性的方式与人类共同工作。这一转型与系统的快速数字化和互联紧密交织,推动了信息物理系统(Cyber-Physical Systems,CPSs)和系统之系统(Systems of Systems,SoSs)的出现。在这些系统中,物理过程与计算、通信和控制系统深度集成,目的是利用过去未得到充分开发的大量数据,实时了解系统状态及行为,从而支持制造、能源、交通、通信、金融和医疗系统的安全、可靠和可持续运行。
物联网(IoT)是上述变革的重要驱动因素。物联网将带有传感器、软件和其他技术的物理设备连接起来,使其能够采集和传输数据。虽然这些进步使实时监控与控制成为可能,但也使工业系统暴露于新的复杂性和脆弱性,例如数据泄露、系统失效,以及技术网络之间的级联影响。此外,现代工业还面临日益增长的灵活性需求。不断变化的客户需求促使制造工厂和发电设施采用可变生产模式,并借助实时数据挖掘、机器学习和自适应调度技术调整运行。
风险评估为风险管理中的知情决策提供重要支持。所需的关注程度、分析精细度以及监管强度,取决于工业领域的安全关键性。例如,核能系统和化工过程设施的事故可能严重危害人员与环境,因此需要更加严格的评估和监管。其中一个重要问题是系统及其安全屏障的老化。老化会降低安全屏障的性能,增加工业现场失效的可能性,削弱安全关键部件的结构完整性,并影响铁路、桥梁和电网等基础设施。为应对这些问题,研究人员已经开发了将老化影响纳入风险评估的方法,利用历史记录和状态监测数据持续更新性能指标,使模型更加准确地反映安全屏障随时间发生的退化。
气候变化(Climate Change,CC)引发的日益强烈的环境应力,也是未来风险的重要来源。极端危险事件的频率和严重程度上升,使工业运行与维护面临更多不确定性。极端天气及其对工业系统和关键基础设施(Critical Infrastructures,CIs)的级联影响,要求重新考虑当前风险缓解策略,并进一步凸显韧性在现代社会中的重要性。气候相关风险可以直接影响大坝、水渠、地下水井等水工和土木工程结构,也可能影响能源系统、电网以及其他关键基础设施。
论文以2025年初洛杉矶野火为例,指出长期干旱和极端高温加剧了火灾,对多个关键基础设施造成严重破坏:超过200条电力线路受损,50多处水务设施受到影响,交通网络大范围中断,数千名通勤者受到波及。在灾害最严重时,近9万户家庭失去电力供应,而通信和供水系统故障又阻碍了应急响应。类似事件说明,灾害会在社区、基础设施和经济活动之间迅速传播,影响范围可能远远超出最初受到冲击的对象。
现代工业风险评估面临的关键问题,是如何预先识别和缓解那些跨越传统系统与领域边界、因复杂相互依赖而产生的动态风险。
从工程角度,风险可以由一组事故场景、各场景的发生概率及其后果表示:
[
\mathrm{Risk}=\{s_i,p_i,c_i\},\quad i=1,\ldots,N. \tag{1}
]
其中,(s_i)表示第(i)个事故场景,(p_i)和(c_i)分别表示该场景的发生概率和后果。风险评估还取决于当时能够获得的系统知识(K),因此可进一步表示为:
[
\mathrm{Risk}=\{s_i,p_i,c_i;K\},\quad i=1,\ldots,N. \tag{2}
]
这意味着风险评估结果与现有知识状态、建模所采用的假设,以及模型参数取值直接相关。新的传感和监测技术,包括无人机、地面移动机器人等,可以提供大量数据、图像及文本,从而不断扩展风险评估所能使用的知识。同时,数据分析、计算建模与仿真技术的进步,使得这些信息能够被更加充分地处理和利用。例如,AI和ML有助于实时风险评估;综合性的计算方法还能考虑网络安全威胁、自然灾害和气候变化不确定性等相互关联的危险。
这些数据驱动技术推动了计算风险评估(Computational Risk Assessment,CRA)框架的发展。CRA利用先进计算工具,在动态而复杂的环境中量化和管理风险。代表性方法包括:利用状态监测数据的基于状态的风险评估(CBRA);考虑危险情形形成过程中系统运行状态演变的动态风险评估(DRA);以及通过物理系统虚拟副本模拟和预测风险场景的数字孪生(DT)。数字孪生还可以结合实时传感器数据,评估洪水等自然灾害下系统的韧性。
本文关注现代工业风险评估中五个具有代表性的研究领域,它们分别对应当前工业系统正在经历的重要变化:
- 灵活且具有能源意识的生产方式不断发展,产生需要先进调度和资源优化来应对的运行风险。
- 工业资产持续老化,因此需要能够纳入退化过程的时变风险评估方法。
- 基础设施数字化程度提高,带来信息物理系统的相互依赖及罕见失效机制,给传统风险评估带来计算挑战。
- 实时监控和IoT技术广泛应用,使能够进行在线风险预测和决策支持的数字孪生成为必要。
- 气候变化加剧自然危险及相互连接的关键基础设施中的级联风险,需要多灾种和长期风险评估框架。
这些主题共同构成了现代工业风险评估需要进一步创新的研究前沿。本文是一篇具有研究展望性质的论文,通过五个主题下的具体研究和应用实例,讨论现代风险评估方法如何适应工业环境的演变,以及这些方法对工程实践的意义。
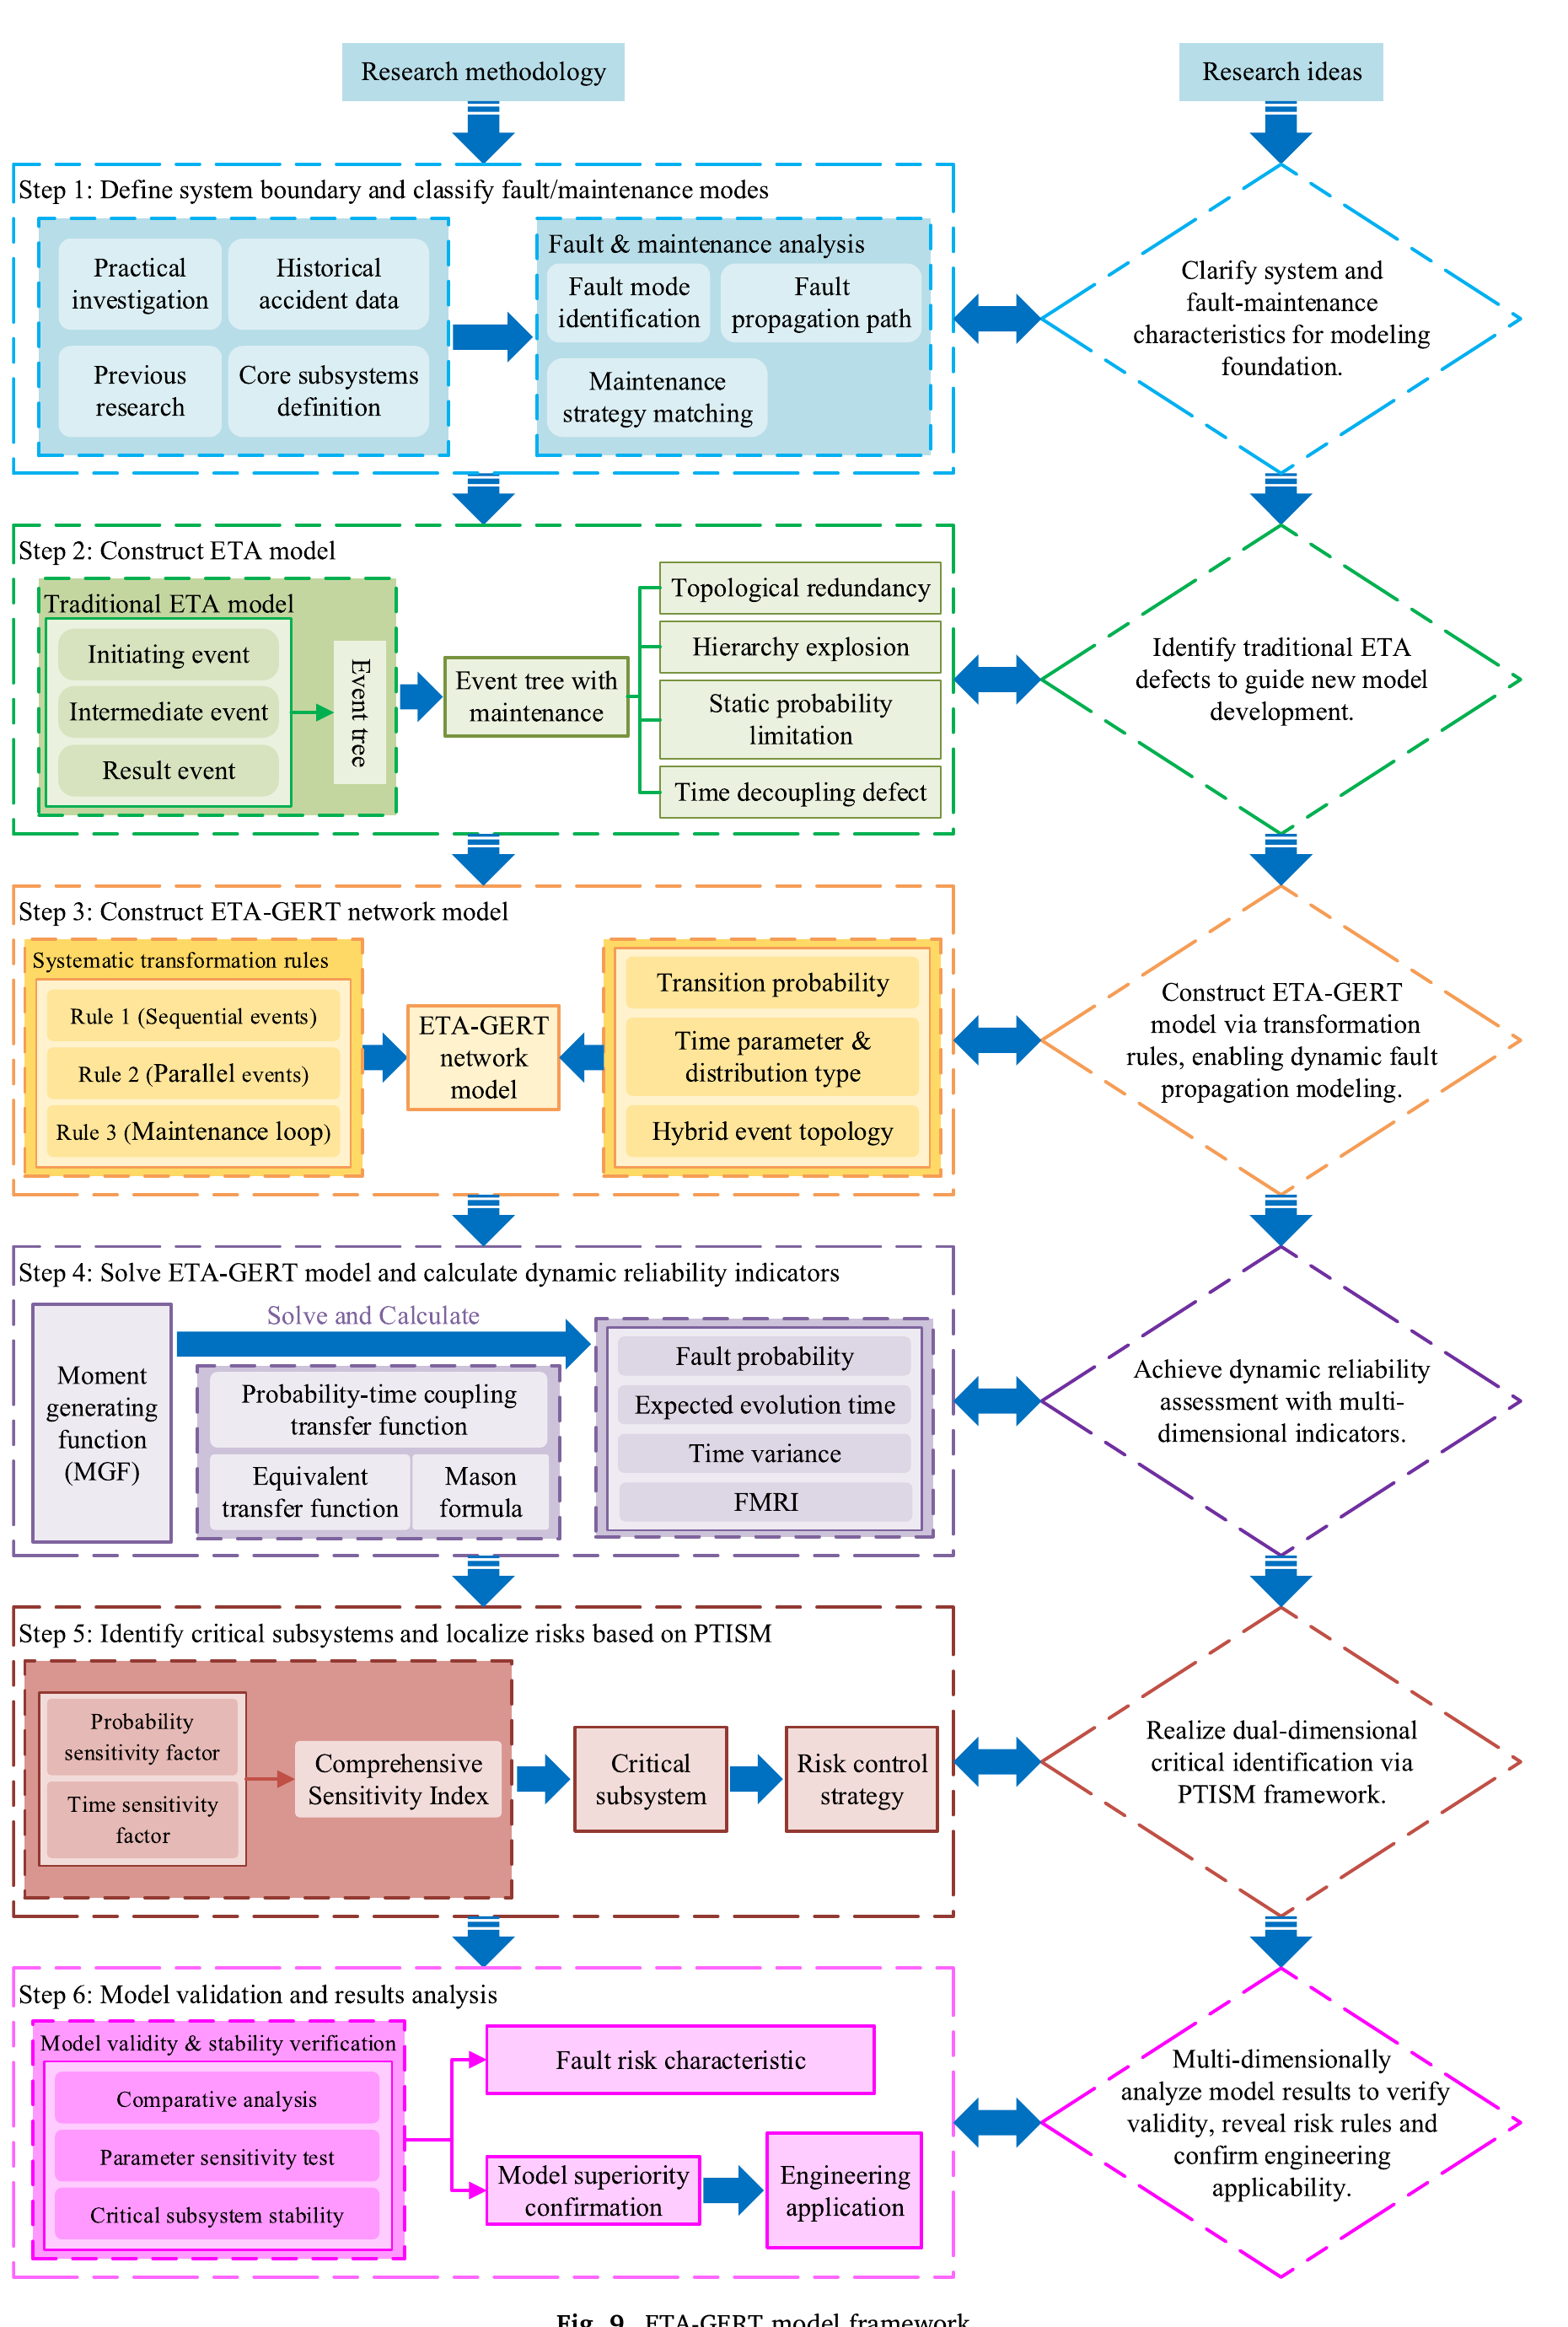
论文首先讨论柔性制造系统中的能源高效生产调度,展示如何结合带时间与能耗属性的Petri网及混合整数线性规划来寻找经济、可靠且节能的生产计划。其次讨论工业安全屏障的时变退化,利用失效物理模型与脆弱性模型建立随危险强度和屏障年龄变化的脆弱性曲面,再通过动态贝叶斯网络分析化工厂风险。随后研究信息物理系统的计算风险评估,利用动态重要性函数引导RESTART罕见事件模拟。第四个主题是面向实时风险监控的数字孪生,以灰箱数字孪生结合仿真和状态数据,支持风险预测与主动控制。第五个主题讨论气候变化、自然灾害与关键基础设施:通过随机模拟评估电力—天然气等能源系统的韧性,使用动态不可运行性投入产出模型分析相互依赖基础设施中的级联失效,并以核废物处置设施说明气候变化对长期风险评估的影响。最后给出新趋势、当前局限和未来研究方向。
2. Energy-Efficient robust production scheduling in manufacturing systems
现代消费市场变化迅速、细分程度越来越高,消费者既要求个性化产品,也要求具有竞争力的价格和更短交货时间。这种变化推动制造企业采用大规模定制,在满足个体客户需求的同时保持接近大规模生产的效率。柔性制造系统(Flexible Manufacturing Systems,FMSs)由此成为重要解决方案,因为它们能够在不显著中断生产的情况下适应需求变化。
制造业又是全球能源消耗的重要行业,因此降低生产过程的环境影响也日益迫切。提高制造过程能源利用效率,已经成为实现环境可持续性的基本目标。FMS的能源高效生产调度可表示为一个联合决策问题:为相互独立的工件任务选择生产计划,把工件和工序分配给机器,并决定各机器上的执行次序,同时综合最小化总完工时间(Makespan)与能源消耗所形成的统一成本。
不合理的调度还可能造成生产延误、资源过度使用、能源浪费和生产瓶颈,进一步沿供应链传播。因此,稳健高效的调度不仅关系到运营绩效,也关系到整个生产系统抵抗扰动及减少系统性脆弱性的能力。
相关研究一方面把能源因素作为约束条件或优化目标,另一方面扩展决策空间,考虑设备状态、工作速度和时间窗口。求解方法包括混合整数线性规划(MILP)、混合整数非线性规划、非线性规划以及Monte Carlo Tree Search、A* Search等元启发式或搜索算法。例如,在分时电价条件下,可以先最小化Makespan,再考虑能源总成本;也有研究将柔性作业车间调度与车辆路径规划结合起来,在工件完工时间、能耗和车间负载之间进行多目标权衡。其他工作则将Petri网离散事件模拟与元启发式、Actor–Critic Reinforcement Learning结合,或者利用数据—虚拟—物理空间与深度强化学习实现实时调度。
然而,随着机器、工件和约束数量增加,大规模FMS调度问题的搜索空间会迅速膨胀,导致传统精确优化的求解时间可能无法满足工业应用要求。
2.1. Proposed method: timed & energy-aware transition petri net
尽管Petri网和数学规划在FMS调度中各有优势,将二者结合以求解最优能源高效调度仍有进一步研究空间。本文介绍的框架把Petri网建模与MILP优化相结合。首先提出带时间和能源属性的变迁Petri网(Timed & Energy-Aware Transition Petri Net,TETPN),同时描述FMS运行中的时间和能量因素;然后构造与其等价的MILP模型。
采用Hybrid Filtered Beam Search Algorithm(HFBSA)搜索TETPN,产生一个初始调度方案以及Makespan的上界。此后,把TETPN仿真生成的调度结果转换为MILP变量初始赋值,作为优化器的Warm Start,以提高求解效率。这一方案被称为PN-Full MILP方法:由Petri网提供完整的可行调度作为MILP求解的热启动信息,而不是让MILP从没有初始方案的状态直接搜索。
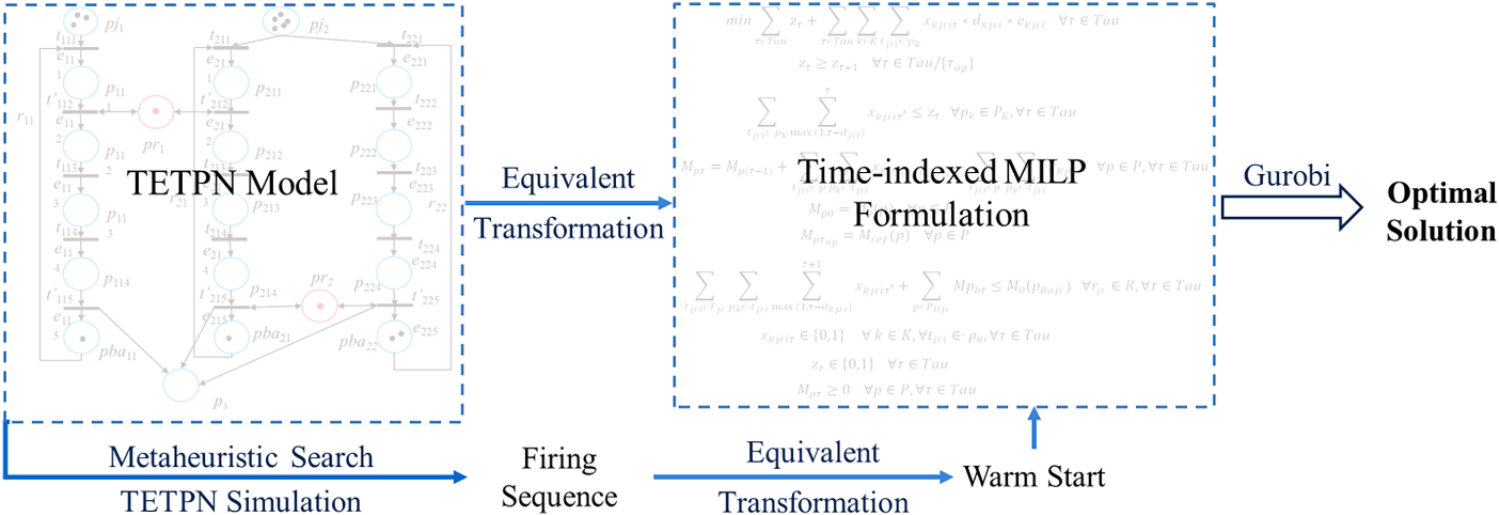
原文 Fig. 1:Flowchart of the PN-Full MILP method.
2.2. Case study
该框架在三个柔性制造系统FMS1、FMS2和FMS3上进行测试。它们具有不同的机器数量、工序数量及可选生产路径,处理五类不同工件,并考虑不同需求场景。各工件的生产计划如Table 1所示。
Table 1:各工件的生产计划。
| 工件 | 可选路径数 | 各路径所含工序数 |
|---|---|---|
| 1 | 5 | [4, 5, 5, 4, 5] |
| 2 | 4 | [5, 4, 6, 5] |
| 3 | 5 | [3, 3, 5, 5, 4] |
| 4 | 3 | [5, 3, 6] |
| 5 | 5 | [3, 5, 3, 4, 5] |
各系统共享机器的程度有明显区别,旨在考察不同Resource Sharing条件下算法的稳健性和可扩展性。Table 2给出了机器配置。
Table 2:FMS机器和可在同一机器上执行的工序。
| 指标 | FMS 1 | FMS 2 | FMS 3 |
|---|---|---|---|
| 机器数量 | 25 | 22 | 17 |
| 共享机器工序比例 | 0 | 0.2 | 0.6 |
| 使用共享机器的工序数 | 0 | 5 | 15 |
| 可执行多个工序的机器数 | 0 | 2 | 7 |
测试需求包括Balanced Production Vectors和Unbalanced Production Vectors。对于生产向量([n_1,\ldots,n_{|J|}]),若任意两类工件需求之间满足(0.2\le n_{j’}/n_j\le5),则定义为平衡需求,代表相对稳定生产中的中等需求变化;不满足这一条件的向量则视为非平衡需求,可用于模拟半导体、航空航天等行业中样机制造与标准产品并行生产的情形。
为验证效率,作者比较三种方法:Direct MILP直接求解MILP;PN-MS MILP仅使用Petri网仿真得到的Makespan估计;PN-Full MILP则使用Petri网给出的完整调度进行Warm Start。三种方法的CPU Time均按照完整Wall-clock Execution统计,因此PN方法包括Petri网仿真与后续MILP求解,而不是只统计最后的优化时间。对小规模测试设置三小时计算上限。
在平衡需求条件下,随着工件数量增加,三种方法的计算时间通常都会增加。PN-MS MILP和PN-Full MILP经常可以在数秒内得到最优解,而Direct MILP通常需要数秒到数百秒。PN-Full MILP整体表现较好,但对于共享工序比例为20%的FMS2,在部分平衡需求场景下,PN-MS MILP可能更快。
在非平衡需求条件下,求解时间的变化更加明显。PN-Full MILP在所有测试场景中均优于Direct MILP;PN-MS MILP也大多优于Direct MILP,但在少量需求量较小的场景中例外。PN-Full MILP在FMS1以及FMS2、FMS3的大多数需求组合上快于PN-MS MILP。值得注意的是,Direct MILP在Figure 3(b)中的一个场景未能收敛,而两种基于Petri网的方法仍保持了较好的求解性能。
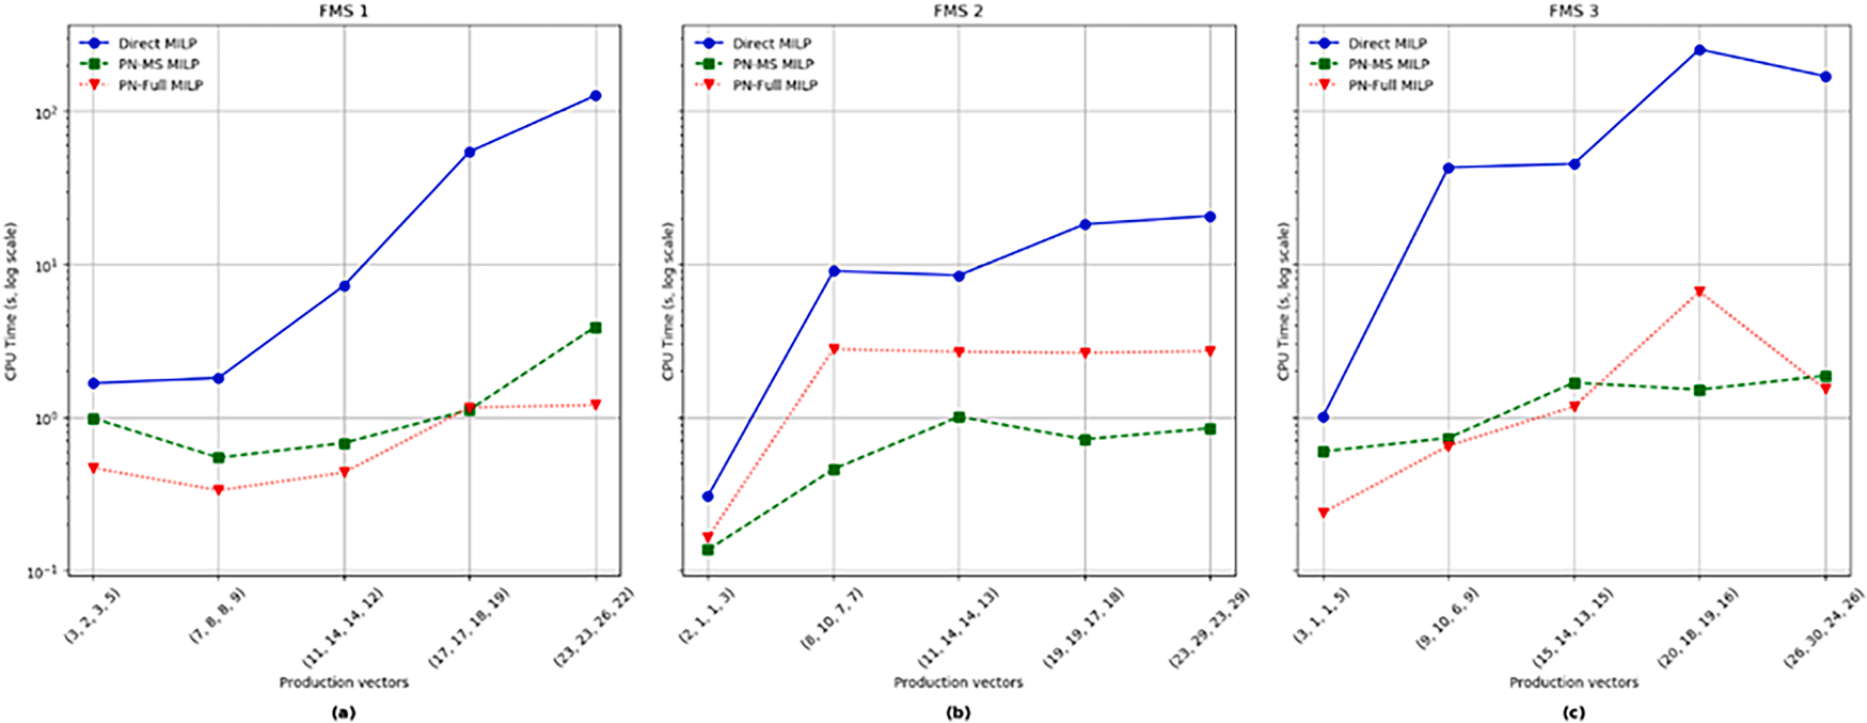
原文 Fig. 2:CPU time of optimal energy-efficient scheduling under balanced production vectors.
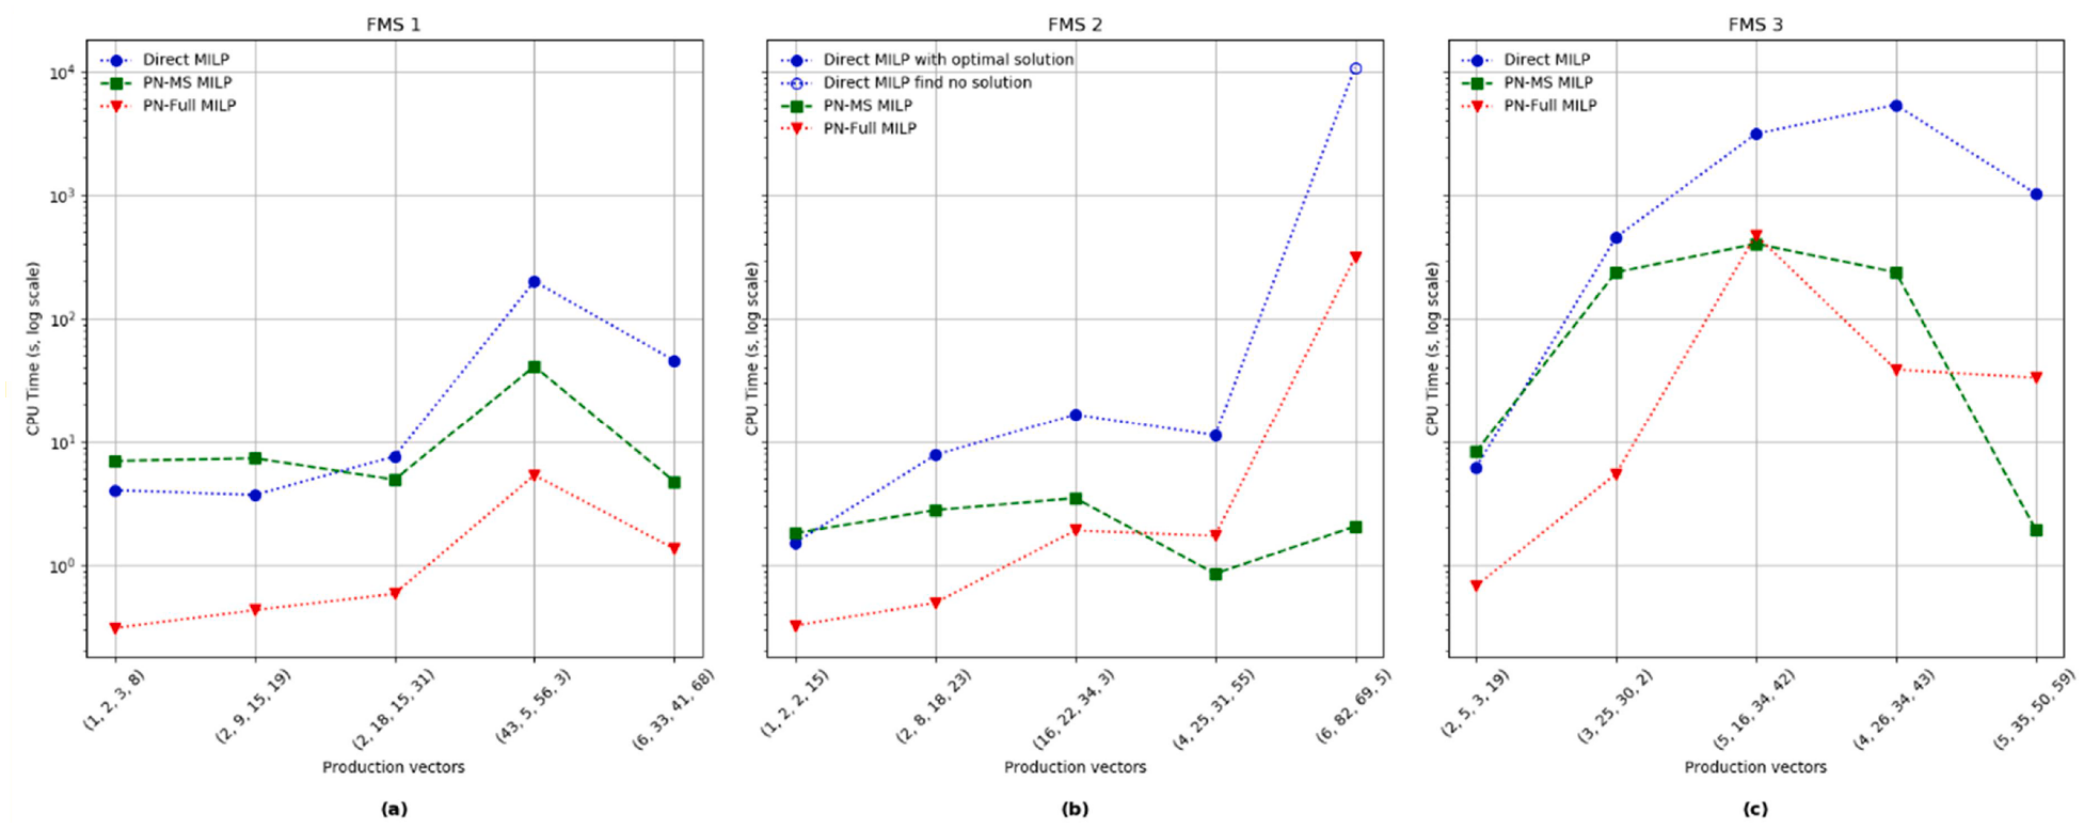
原文 Fig. 3:CPU time of optimal energy-efficient scheduling under unbalanced production vectors.
总体上,Direct MILP需要明显更多的计算资源,计算时间从不足一秒到数万秒不等。完整Petri网调度提供的热启动能够在保持最优求解目标的同时,显著改善能源高效生产调度的计算效率。
2.3. Remarkable findings
研究提出的TETPN可以同时描述FMS运行的时间与能源因素,所得仿真结果可以用作离散时间MILP最优能源高效调度的Warm Start。不同生产场景的结果表明,基于Petri网的MILP方法通常比直接求解MILP效率更高。这种效率具有实际风险管理意义,因为不合理的调度会产生生产流程瓶颈、能源浪费、成本增加和交货延迟,并进一步导致制造生态系统中的级联脆弱性。
但目前框架仍有局限。HFBSA在Reachability Graph探索中使用固定Beamwidth,可能限制Warm Start方案的质量及整体求解效率。此外,当前实现将Makespan和Energy Consumption合并为一个统一优化目标,限制了其对某些真实生产决策的适用性;模型也没有考虑Machine Failure及其他随机事件,而这些因素可能影响调度结果的质量。
未来可在框架中加入设备故障、Processing Time Variation等随机因素,使调度在不确定条件下更加稳健。意外机器故障可能中断整条生产线、造成质量问题和异常能耗,因此能够响应扰动的调度策略尤其重要。进一步的研究还将处理多目标优化,并考虑利用Reinforcement Learning等AI技术进行动态、自适应的生产调度,使系统能够在不断变化的制造条件下持续调整资源配置和风险缓解措施。
3. Risk assessment considering the degradation of safety barriers
安全屏障的作用是防止工业系统发生事故,或者减轻事故发生以后的后果。然而,安全屏障本身也会随时间退化。已有针对安全屏障性能的简化Risk Index、Monte Carlo Simulation和Bow-Tie Diagram等方法,往往没有充分考虑这种退化的影响。因此,风险评估应当纳入安全屏障随时间变化的性能,并在获得有关其实际状态的新信息以后更新风险概况。
传统Fragility Model主要描述在给定Hazard Magnitude条件下安全屏障发生失效的概率。为了表示老化,必须进一步引入时间维度,使屏障Fragility与其Age和Degradation Process相关。安全屏障失效概率不能只由外部危险强度决定,还应考虑屏障自身因老化而不断变化的抵抗能力。
3.1. Proposed method: fragility surfaces for time-dependent degradation of safety barriers
该方法在前期研究的基础上,将失效物理(Physics-of-Failure,PoF)模型描述的时变退化纳入传统Fragility Analysis,从而在Risk Framework中动态更新安全屏障的Failure Probability。具体而言,通过两类模型建立Age-dependent Fragility Surface:PoF Model描述屏障随时间如何退化,以及这种退化最终可能如何导致失效;Fragility Model则描述Failure Probability如何随Hazard Magnitude变化。
为了连接这两类模型,PoF Model计算得到的Barrier Degradation State作为Fragility Model的输入,再由Fragility Model估计安全屏障失效概率。这种PoF-based Framework既可用于暴露在极端自然事件下、随时间老化的安全屏障,也能考虑多组件或多单元之间共享的安全屏障。例如,多机组核电站可以共享应急堆芯冷却系统(ECCS)或余热排出系统(DHR),相关风险评估还必须考虑这种共享屏障的共因失效(Common Cause Failures,CCFs)。
在一个一般的风险更新时间(t),模型框架按照如下步骤运行:
- 系统和危险表征:通过Magnitude–Frequency Curve表征自然危险,通过Physical Properties表征系统,通过Age-dependent Fragility Surfaces表征安全屏障性能,并通过CCF Models刻画共享屏障的共因失效。
- 事故演化建模:建立事故场景随时间演化的动态模型,例如Dynamic Bayesian Network(DBN)。
- 风险计算与决策:计算系统失效概率及事故后果严重程度,得到Location-specific Individual Risk(LSIR)。如果风险超过允许的安全限制,则决定适当的缓解措施,并回到第一步更新模型。
- 运行中的更新:系统运行一段时间(\Delta t)后,可以获得新的Hazard Information和System State Knowledge,因此重新回到第一步,并更新风险模型与评估结果。
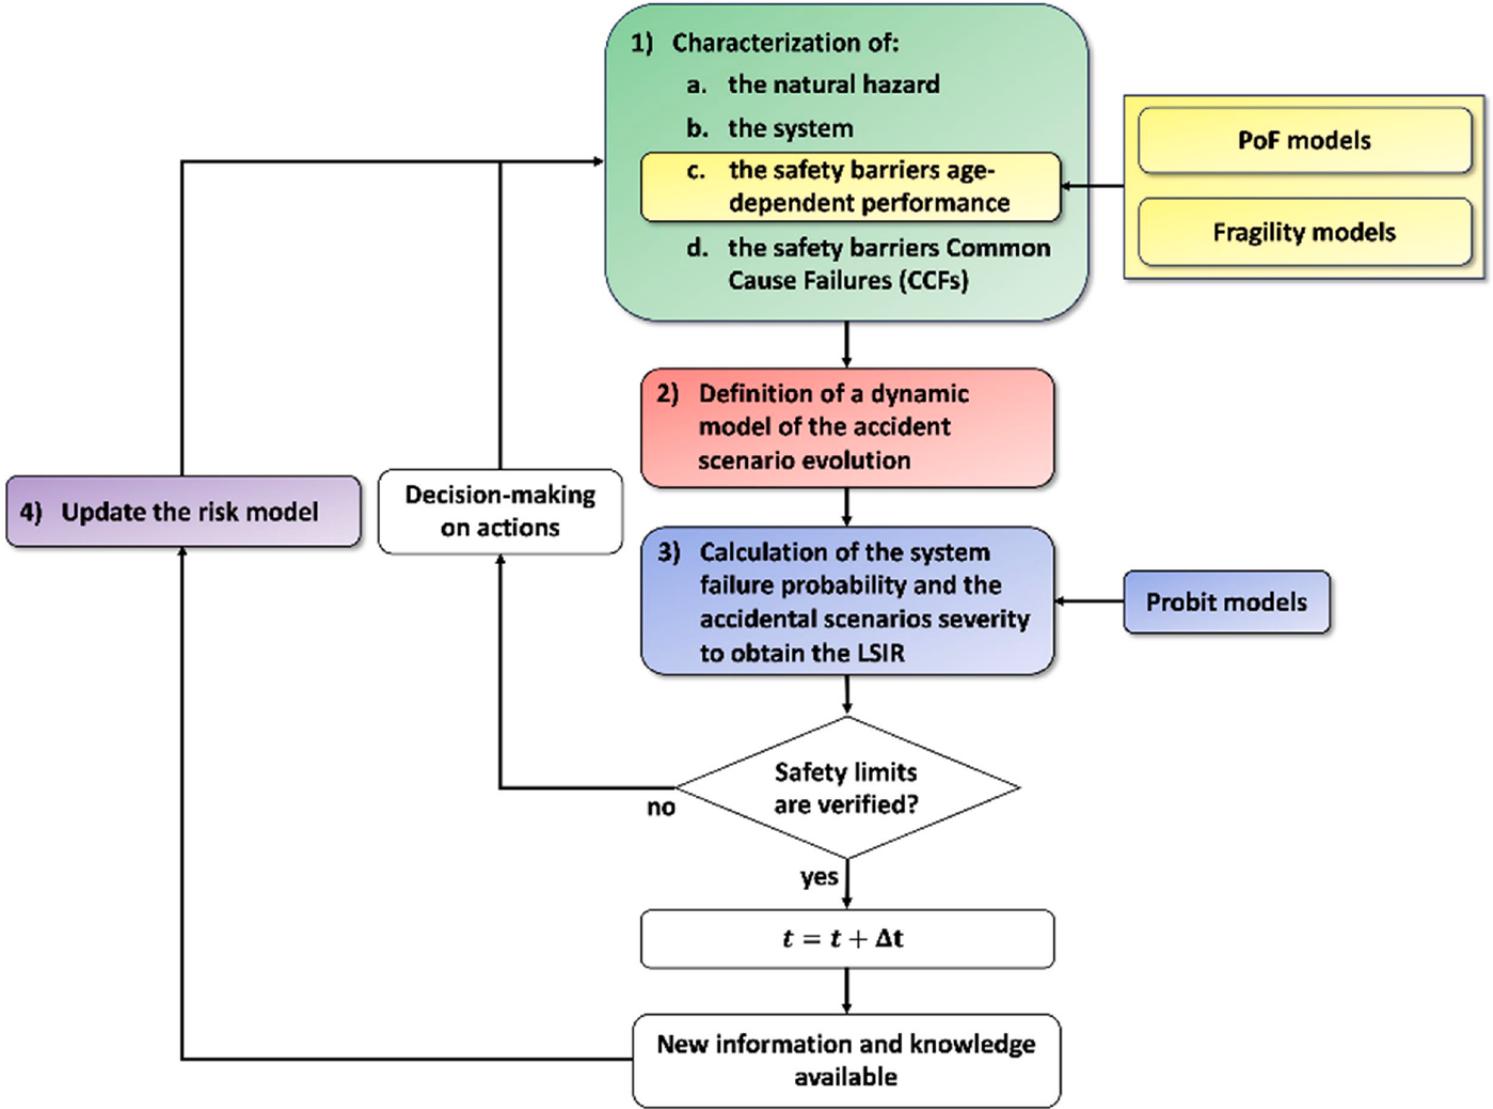
原文 Fig. 4:Flowchart of the PoF-based modeling framework.
3.2. Case study
该框架应用于文献中的一座化工设施。设施包含两个储存液态易燃物质的常压储罐T1、T2,以及一个储存液化石油气的承压容器P1。系统配置了多个安全屏障,包括Water Deluge System、Passive Fire Protection Coating、Pressure Safety Valve、Foam-water Sprinkler System以及Emergency Team Intervention(ETI)。设施设计寿命为50年,面临强地震危险。
为了说明方法,研究假设任意储罐失效后都将发生火灾:T1和T2发生Pool Fire,P1发生Jet Fire,两种情况下最终完成事故缓解均需要150 min。一个储罐失效后,其长期火灾热辐射可能继续导致其他储罐失效,从而产生Cascading Failures。
事故场景演化由DBN建模。选择DBN是因为它能够灵活地表达动态环境中各事件、组件之间的概率依赖,而且与传统Monte Carlo方法相比,计算负担相对较低。DBN还可以在获得新Evidence以后更新Risk Profile,因此适合比较不同缓解措施的效果。
研究假设在设施寿命内的三个时间点获得新的信息:
- (t=8)年时发现,由于最近的Emergency Team Station迁移,ETI安全屏障响应时间的不确定区间变大。
- (t=14)年时获得新的全球Seismic Hazard Map,可以更新附近地震导致Peak Ground Acceleration(PGA)的Magnitude–Frequency Curve。
- (t=23)年时,由于企业采取更加积极的经营策略,储罐需要储存超过最初设计工况的易燃物质数量。
新证据和运行条件变化使设施的风险随寿命明显上升。研究随后比较相应的风险控制措施:第8年为常压储罐增加Fireproof Coating;第14年安装Energy-dissipating Anchors;第23年升级Sprinkler Systems。采取措施以后,再利用更新后的DBN和Fragility Surfaces重新评估LSIR。
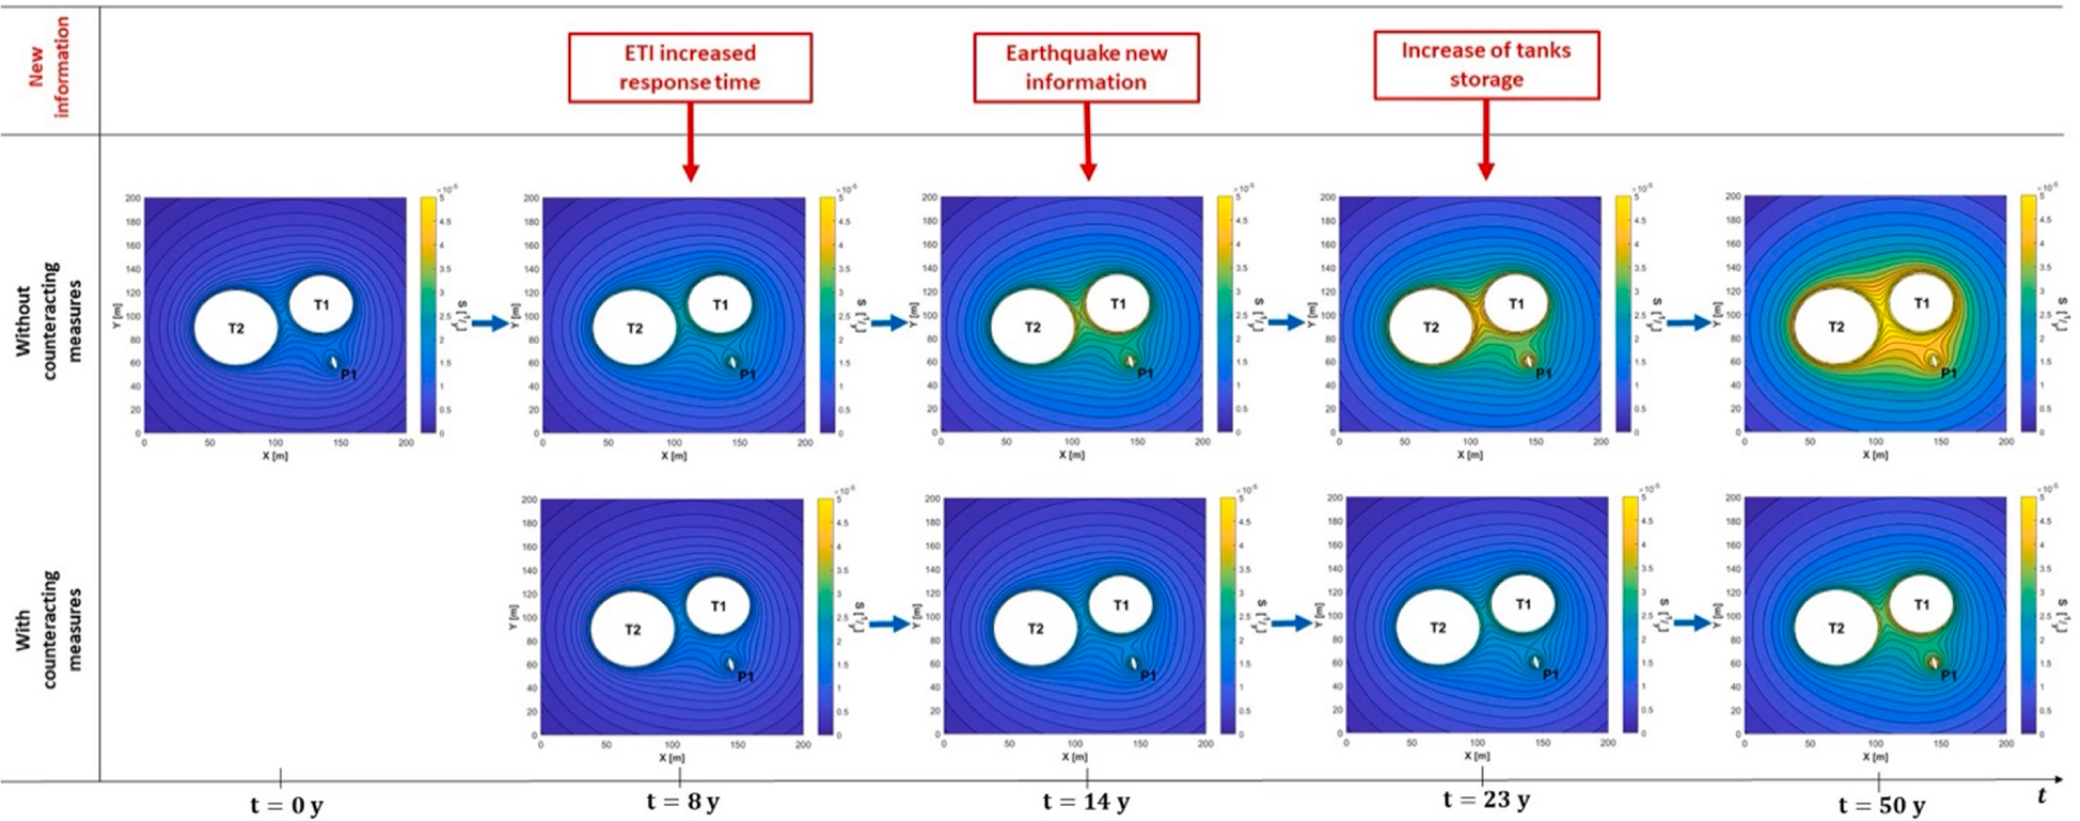
原文 Fig. 5:LSIR contour throughout the system life.
3.3. Remarkable findings
案例结果说明,安全屏障的退化会显著改变设施的风险,因此必须将其纳入风险评估;同时,所提出的框架能够利用新信息动态更新风险概况,为设施全寿命期内采取适当措施提供依据。
不过该方法仍有三项主要限制。首先,构建Fragility Surfaces需要同时具备PoF Models和Fragility Models,而这些模型未必总是可以获得。其次,Dynamic Model的计算负担较大,当系统复杂或事故场景很多时,可能达到无法接受的程度。最后,由于系统和Simulation Model本身复杂,识别真正有效的Mitigation Action并确定最有影响的参数仍然困难。
未来研究将关注提高框架计算效率,例如使用AI-based Methods;开发Sensitivity Analysis以识别关键参数和有效Mitigation;以及把风险评估框架与Risk Management Decision Optimization结合,例如使用Deep Reinforcement Learning(DRL)寻找适当的风险控制策略。
4. Computational risk assessment of cyber-physical systems
信息物理系统将物理过程与分布式计算智能集成到能源、交通和医疗等关键领域,使传统安全方法难以完整描述系统内部的复杂交互。计算风险评估(CRA)可以通过建立CPS模型、模拟系统对扰动的响应,并对仿真结果进行后处理,识别导致系统性能退化的因素。
但CPS的CRA面临三个困难:物理模型的计算成本可能很高;随着Subsystem数量增加,可能的Operational States呈组合式增长;在这些状态中,只有极小一部分会使整个CPS发生Failure。最后一个问题属于Rare-event Problem,使用Crude Monte Carlo Simulation往往需要非常大量的样本才能观察到足够多的罕见失效。AI Surrogate能够加快模型计算,但罕见事故数据通常不足,其可解释性也难以满足Safety-critical Application的要求。
因此,已有研究提出Rare-event Simulation方法,以更加高效地采样能够触发关注事故的低概率事件。在CPS中应用这些方法仍需处理高维状态空间与动态State Transition Process。本文介绍Splitting Technique,特别是RESTART(Repetitive Simulation Trials After Reaching Thresholds)。它能够用于相互依赖的Hybrid Dynamic Systems,但前提是必须构造适当的Importance Function(IF),引导模拟过程朝向系统Failure Region探索。
4.1. Proposed method: restart for efficient CPS scenario generation
RESTART的基本过程可用二维状态空间加以说明。首先定义Importance Function (\phi),将随时间变化的CPS Process Variables映射为一个Scalar Value,表示系统当前State的重要程度。所提出的适用于CPS的(\phi),通过同时考虑两个方面量化CPS在仿真场景中的Vulnerability:一是受到Hazard或Threat影响的Subsystem在网络中的Centrality;二是该Subsystem随时间变化、可能发生Disruption或Failure的Susceptibility。
定义(\phi)以后,在其取值范围内设置一系列逐级提高的Importance Thresholds,从而划分State-space Region。每个Threshold还对应一个Retrial Number,用于后续的Splitting Process。
RESTART算法具体包括:
- 运行Main Trial,即一次Monte Carlo Simulation,同时跟踪Importance Function (\phi)。
- 记录(\phi)向上穿越某个Threshold的时刻,以及该时刻对应的CPS State。
- 对每一次Up-crossing,从记录的状态与时刻重新启动指定数量的Retrials;这些Retrials持续到Simulation End Time,或者(\phi)再次向下穿过相同Threshold。如果(\phi)一次跨越多个Threshold,则需相应增加Retrials数量,以正确计算概率。
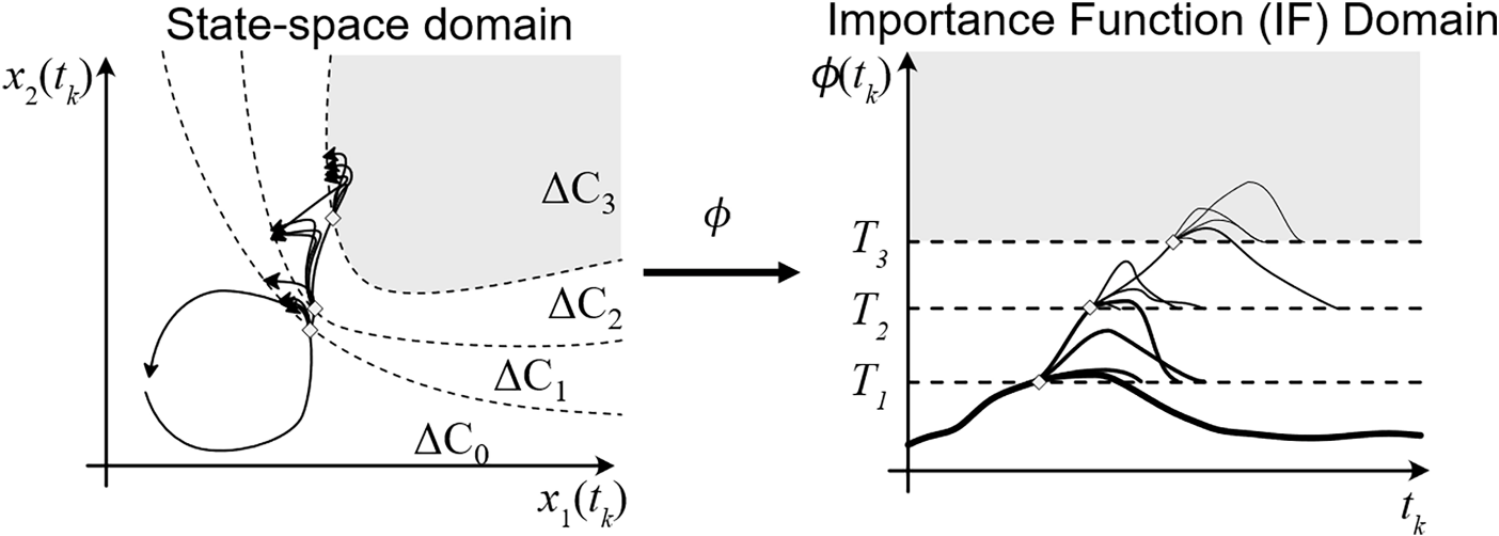
原文 Fig. 6:Visualization of RESTART for a two-dimensional state.
多维CPS过程仍然遵循自身Dynamics,由Co-simulator执行。RESTART并不替代物理模型,而是根据仿真中计算的(\phi)决定如何分配重复模拟的计算资源。
这一方法的基本依据是,系统状态通常更容易从较低Importance Region进入相邻的中等Importance Region,而不是直接跨越多个区域。通过在中等Importance区域增加采样,有机会以更低的计算成本观察到具有更高Importance的罕见状态。
适当的IF对于RESTART十分关键。有效的IF应当:为高概率状态赋予较低Importance;使Threshold附近的相邻状态具有相近Importance;并尽量避免Importance Skipping,即一次跳过多个区域。
过去使用过的IF包括Power Grid中失效线路的数量、系统Minimal Cut Sets,以及Energy Not Supplied(ENS)、System Average Interruption Frequency Index(SAIFI)等Vulnerability Metrics。但Cut Set很难在大型CPS中识别;ENS等指标则通常需要系统已经出现失效以后才产生非零值,因此无法在事故真正出现前有效引导采样。如果整个Simulation中没有Failure,使用这类IF的RESTART可能退化成Crude MCS。
为解决这一问题,研究提出Dynamic Network-level Vulnerability(DNV)作为新的Importance Function。DNV结合网络节点的Centrality与反映实时应力、容量使用程度的Dynamic Susceptibility,使RESTART能够在实际故障出现之前识别更接近失效的系统状态。
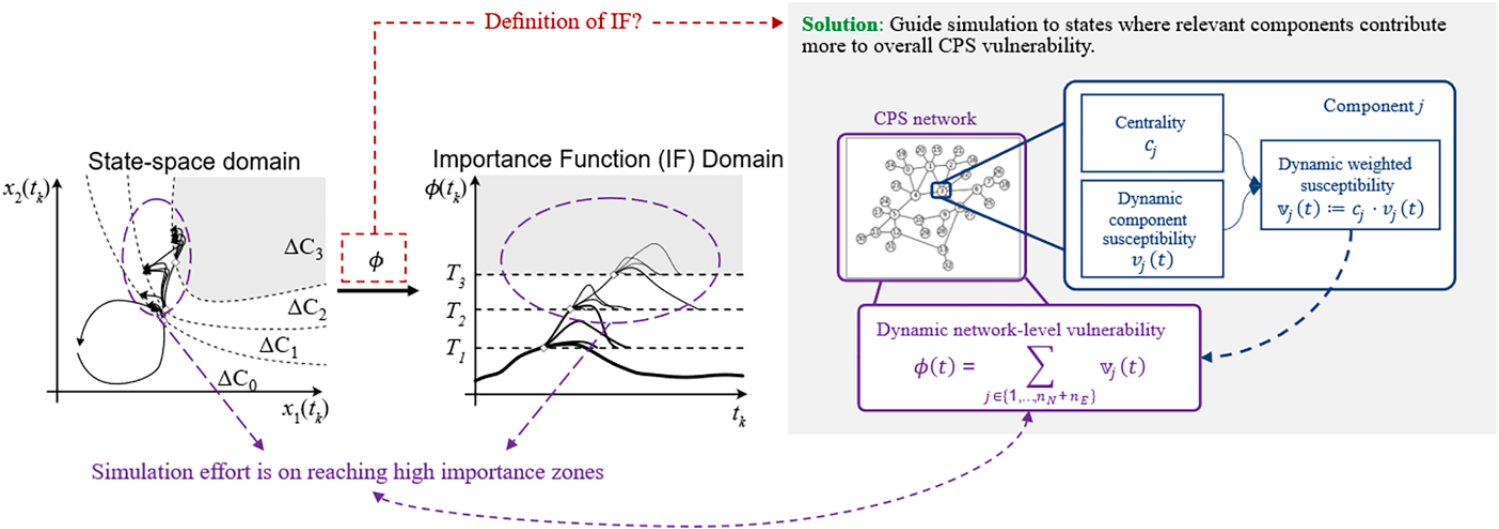
原文 Fig. 7:RESTART applied on a 2-state system and the definition of the novel IF.
4.2. Case studies
该方法在一个CPS案例上测试:IEEE 14-bus Power Grid及其Centralized Controller。运行时,部署在电网中的Smart Monitoring Devices持续向Control Center发送数据(Bottom-up),而Control Center向电网Power Injection Devices发送Control Actions(Top-down)。外部随机输入来自意大利Terna公开数据,经处理后模拟随时间变化的Customer Power Demands。Component可以按照常数Failure Rate和Repair Rate发生故障与修复。
研究比较四个Importance Functions:
- (\phi_1):Power Generation Mismatch(PGM);
- (\phi_2):失效Component数量;
- (\phi_3):Energy Not Supplied(ENS)的百分比;
- (\phi_4):新提出的Dynamic Network-level Vulnerability(DNV)。
评价指标为Exploration Efficiency (\xi_\phi(T)),表示模拟生成的全部采样点中,落入由Threshold (T)定义的重要性区域的点所占比例。随着Threshold上升,若这一比例比较均衡地下降,意味着相邻Importance Zones之间的Conditional Transition Probabilities接近,因而更符合RESTART的理想执行条件。
原论文Table 3比较了四个IF在Crude MCS及不同RESTART引导方式下的表现。为便于保留原始数据,下面列出各个IF对应的两个Threshold上的Exploration Efficiency。
Table 3:IEEE14案例中MCS与RESTART的性能比较。
| 方法 | 仿真数量 | φ₁:T₁ | φ₁:T₂ | φ₂:T₁ | φ₂:T₂ | φ₃:T₁ | φ₃:T₂ | φ₄:T₁ | φ₄:T₂ |
|---|---|---|---|---|---|---|---|---|---|
| MCS | 40,648 | 0.0129 | 0.0080 | 0.0653 | 0.0059 | 0.0000 | 0.0000 | 0.4667 | 0.1974 |
| RESTART–φ₁ | 30,280 | 0.8327 | 0.8327 | 0.8349 | 0.0375 | 0.0000 | 0.0000 | 0.9216 | 0.8801 |
| RESTART–φ₂ | 32,287 | 0.0662 | 0.0478 | 0.3254 | 0.0548 | 0.0000 | 0.0000 | 0.5246 | 0.3257 |
| RESTART–φ₃ | 32,193 | 0.0246 | 0.0148 | 0.0854 | 0.0056 | 0.0000 | 0.0000 | 0.4810 | 0.2136 |
| RESTART–φ₄ | 38,218 | 0.5717 | 0.5486 | 0.6040 | 0.0467 | 0.0000 | 0.0000 | 0.9683 | 0.8921 |
Crude MCS在所有IF下都把更多计算资源分配给高概率场景,即正常运行或者不会显著改变电网状态的故障。对于ENS指标(\phi_3)尤其明显:其Exploration Efficiency全部为零,表示仿真没有进入用户无法得到电力的场景。由DNV计算的低Importance Region也显示,Crude MCS产生的大量Simulation Points仍停留在最普通的系统状态中。
使用RESTART以后,多数IF的Exploration Efficiency都高于Crude MCS,表明RESTART通常能够生成更多相关场景;但基于ENS的(\phi_3)仍然无法发挥引导作用。其他传统IF也存在两个Threshold之间分布不够平衡的问题。相比之下,DNV (\phi_4)表现出所希望的、相对稳定的Threshold间变化,说明它更适合引导CPS事故场景生成。
4.3. Remarkable findings
研究表明,针对CPS设计的RESTART及新型DNV Importance Function能够提高State-space Exploration Efficiency,与Crude MCS或由传统Vulnerability Metric引导的RESTART相比,更多模拟点进入较高Importance Region。其性能改善来自同时考虑Network Centrality和Dynamic Susceptibility,使方法能够反映不同Subsystem在网络中的作用以及实时应力水平。
研究还发现:RESTART的探索效率高度依赖所选IF;传统Vulnerability Metrics难以有效引导算法生成真正相关的CPS Failure Scenarios;DNV在Exploration Efficiency指标上优于比较方法。由于RESTART本身不限制系统Dynamics,这种方法原则上可扩展至其他CPS应用,而不必对底层动力学作重大修改。
但是,实际事故触发条件不可能总是事先完整描述。CPS Failure可能来自不断演化的交互和级联过程,因此预先定义的Importance Function可能不完整、存在偏差,甚至具有误导性。未来研究需要对RESTART Hyperparameters和DNV进行更全面的Sensitivity Analysis,并建立自适应机制,使Importance Function能够响应不断变化的Accident Conditions。
5. Digital twins for risk assessment
数字孪生(Digital Twins,DTs)通过集成实时数据、建模与仿真技术,为物理资产建立虚拟副本,从而支持风险评估。一个数字孪生通常由三个基本部分组成:Physical Object(PO)、Digital Object(DO)以及连接二者的Twinning Processes,其中包含从物理到虚拟的P2V和从虚拟到物理的V2P过程。这些过程使Digital Layer能够与Physical Layer保持一致。
数字孪生的特点在于,Digital Object中可以包含规模较大、结构复杂且具有随机性的模型,并在Physical与Digital Layers之间建立闭环,使数字模型能够自动更新,同时支持及时采取控制措施。DT能够实时监测和模拟潜在风险,从而提高安全性与效率。数字孪生与Simulation、Data Processing和IoT技术结合,可进一步增强Risk Management与Safety Analysis能力。
由于物理系统需要在正常工况和事故场景中运行,部署之前往往需要大量测试。因此,Rare-event Simulation非常重要,可以利用Physics-based Models或Surrogate Models探索不常见但后果严重的状态。与此同时,数字孪生需要借助实时传感器数据持续反映复杂系统的运行状态,以尽早发现Faulty States和Accident Conditions。
现有Risk Assessment应用包括:通过自动执行RAMS分析优化系统设计;通过虚拟模拟施工过程,提前识别Worker Safety Hazards;以及辅助满足监管要求,降低项目延误和违规成本。不过,数字孪生在Risk和Security方面仍存在明显研究缺口。DT必须保证不同生命周期阶段的数据完整、一致、最新且可追踪,还需要解决Standardization、Communication Protocol、Data Management、Cybersecurity和Lifecycle Persistence问题。特别是当DT用于Risk Assessment与Emergency Management时,这些问题更为突出。
在核电站(NPPs)场景中,Risk Monitoring是支持安全运行与维护的重要功能。Risk Monitor可以视为Living Probabilistic Safety Assessment(PSA)的一种实时分析工具:根据电站当前Configuration评估风险水平,并为Maintenance Scheduling、Operational Adjustment和Response Strategy等决策提供Point-in-time Risk Metrics。通过持续使用运行数据,风险监控能够不断更新电站Risk Profile。
灰箱模型(Grey-Box Model,GBM)通过结合基于物理的White-Box Model(WBM)和数据驱动的Black-Box Model(BBM),在Transparency、Accuracy和Computational Burden之间取得折中。本文介绍将其用于核电站在线风险监控的Grey-Box Digital Twin(GBDT)框架。
5.1. Proposed method: grey-box digital twin
该方法面向NPP Online Risk Monitoring,详细模型及假设在作者先前研究中给出。其主要组成包括Physical Object、Digital Object、Risk Monitoring Module以及Control System。部署于核电站的Sensors把实时监测参数和Safety-critical Variables传送到Digital Object,即Digital Model Repository;Digital Object再执行其中的WBM和BBM,实时估计核电站可测与不可测变量。
WBM和BBM彼此交换信息,共同生成NPP State Prediction。这些变量进一步输入Risk Monitoring Module,产生实时风险指标,例如瞬时Core Damage Frequency(CDF)、Large Early Release Frequency(LERF)或Probabilistic Safety Margins(PSMs)。随后,Control System根据Risk Metrics和核电安全规程采取自动或人工控制动作,使Physical与Digital Layers之间形成双向反馈,完成V2P Twinning。
灰箱数字孪生的核心作用,是把实时状态监测数据与物理仿真、数据驱动预测及风险度量联系起来,使核电站能够在运行和异常条件下连续更新风险估计。
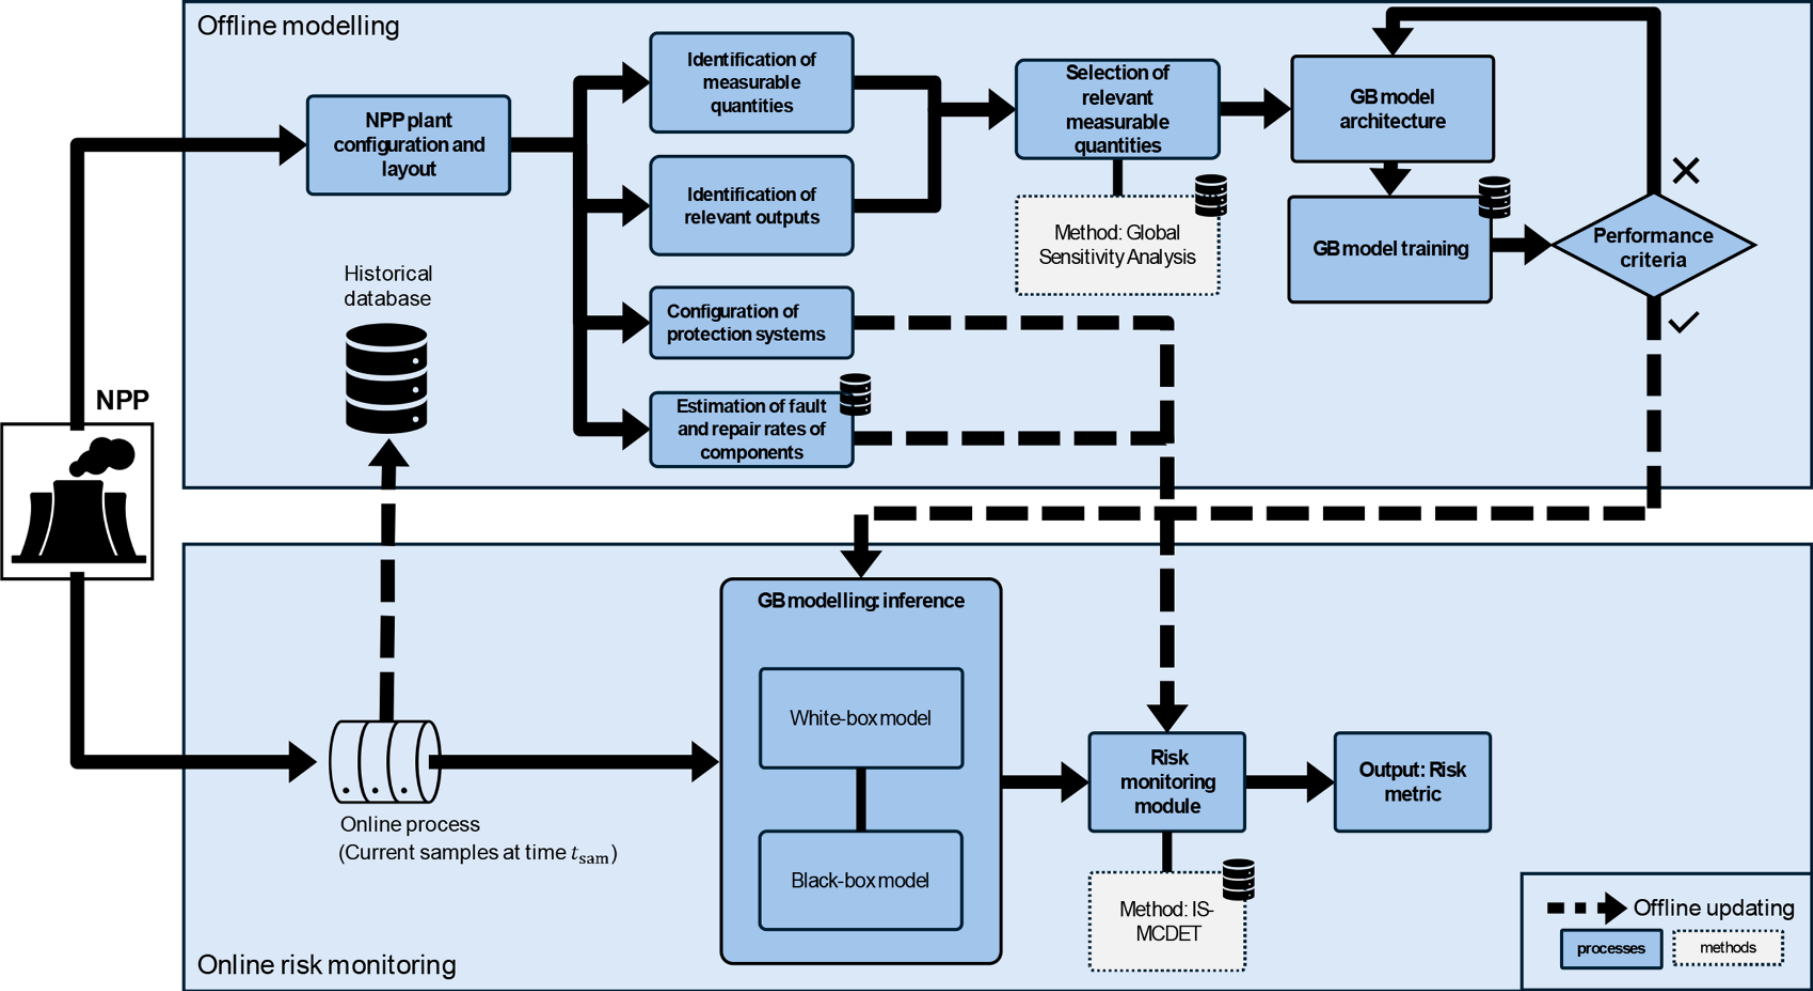
原文 Fig. 8:GB modeling approach workflow for online risk monitoring.
所提出的灰箱框架将Condition-based Monitoring Data与Computational Models融合,使风险评估在传感器覆盖有限的情况下仍能保持一定精度。框架还特别重视Computational Efficiency,使其能用于具有实时响应要求的Risk Monitoring。BBM根据Condition Monitoring Data预测Reactor Dynamics,计算效率较高的WBM则用于模拟Accident Scenario中的关键Safety Variables。为提高预测精度,BBM还对WBM输出与实际之间的偏差进行修正,从而在保留物理一致性的同时提高Accuracy。
为了进一步估计Risk Metrics,方法使用Importance Sampling Monte Carlo Dynamic Event Tree(IS-MCDET)。它在Dynamic Event Tree中采用Multiple Importance Sampling,重点探索低概率、高后果事故场景,并计算PSMs。由此可在当前NPP Configuration和Condition Monitoring Data基础上持续更新风险指标,使Digital Object与真实系统的当前状态保持相对同步。
5.2. Case study: small modular dual fluid reactor
该方法应用于Small Modular Dual Fluid Reactor(SMDFR)的在线风险监测与控制。案例考虑Loss-of-Coolant Accident(LOCA),其发生时刻和事故规模通过MCS随机生成;Physical Object的响应则由Simulation Model模拟。Initiating Event在Simulation Time (t_{sim}=500\,\mathrm{s}) 时触发。
针对LOCA的保护系统为Auxiliary Cooling System(ACS)。ACS也可能失效,进而影响事故期间Peak Cladding Temperature(PCT)等Safety Variables。PCT对应的Safety Margin是监控的重要对象,因为它关系到Abnormal Operating Procedures(AOPs)的启动。
Figure 9展示了模拟事故过程中风险指标的时间演化,并比较两种PSM估计方法:IS-MCDET和Crude MCS。两者都使用GBM估计PCT,并把其时间依赖预测输入Dynamic Event Trees,分析不同Operational Conditions与ACS Failure条件下的事故发展。各Time-state Diagram显示PCT随时间的演化以及可能的分支状态。PSM通过计算Safety Threshold被超越的概率及单侧上容许限进行估计。
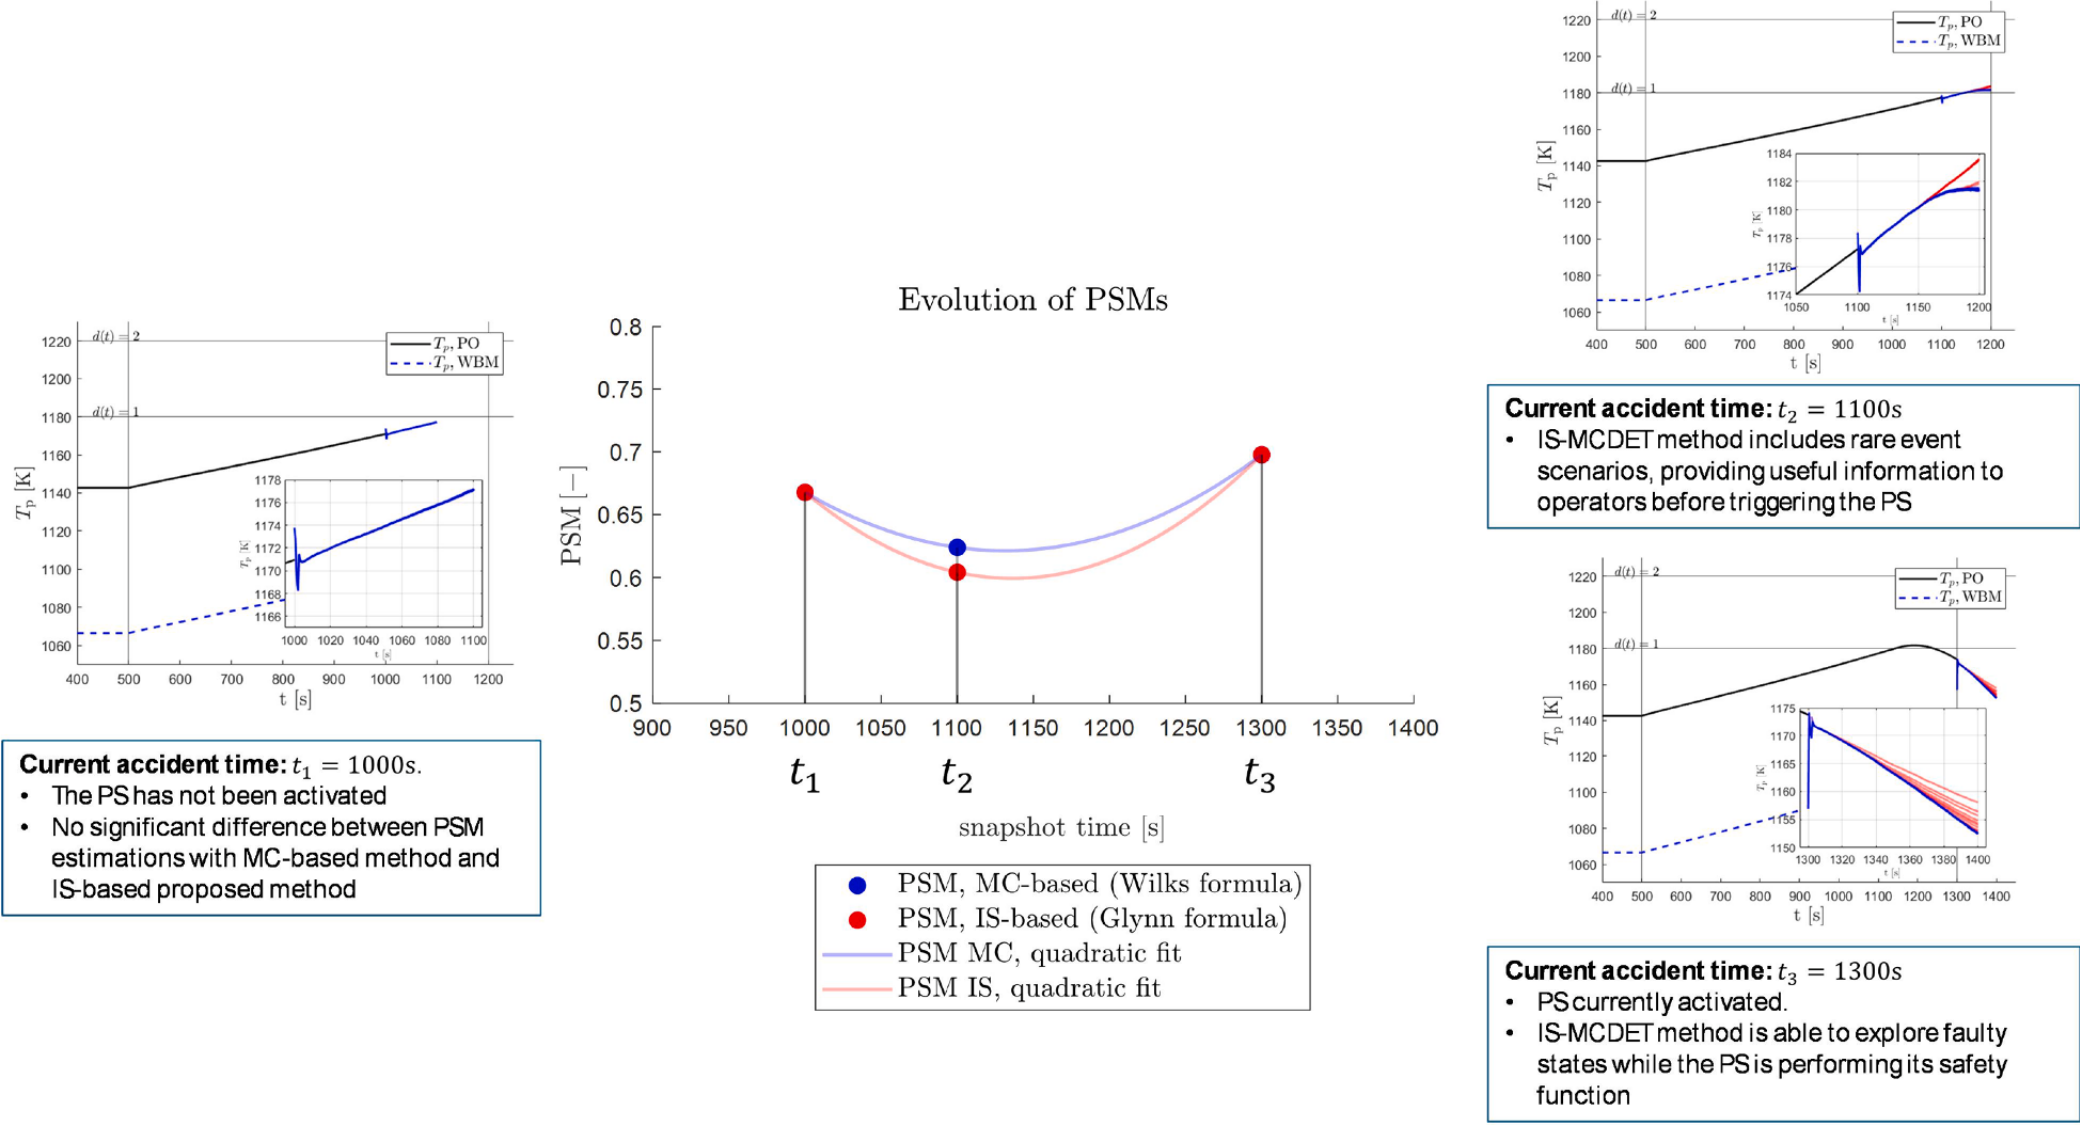
原文 Fig. 9:Risk monitoring process and evolution of PSM estimates during a simulated accidental scenario.
两种方法均可产生Time-dependent PSM Estimates,但由于Rare-event Information的使用方式不同,结果会出现差异。Crude MCS没有主动偏向Failure Region采样,因此低概率、高风险的Accident Scenarios在样本中可能不足;IS-MCDET通过调整Sampling Probabilities,专门增加Protection System Failure相关稀有场景的探索。Figure 9中的若干Time Snapshots表明,IS-MCDET给出的Safety Margins略低于Crude MCS,因此对应的Risk Assessment更加保守。PSM随时间波动也说明风险不是单一静态值,必须在运行中持续监测。
研究进一步把GBM与独立的WBM(Zero-dimensional Model)及BBM(Recurrent Neural Network,RNN)比较,评价Accuracy、Explainability和Average Computation Time。GBM基于High-fidelity Simulation与Zero-dimensional Model生成的LOCA场景数据进行训练。
Table 4:所提出灰箱模型与独立白箱、黑箱模型的性能比较。
| 指标 | 独立WBM | 独立BBM | 所提出GBM | 监管或应用要求 |
|---|---|---|---|---|
| Accuracy(RMSE) | 不满足 | 满足 | 满足 | RMSE不超过当前Instrumentation允许的误差:(\mathrm{RMSE}\le1.89\,\mathrm{K}) |
| Explainability(SHAP) | 满足 | 不满足 | 满足 | 结合可解释方法验证模型输出的物理一致性,以获得终端用户信任 |
| Average Computation Time per Query | 不满足 | 满足 | 满足 | Risk Monitor响应时间不超过两分钟:(t_q\le120\,\mathrm{s}) |
WBM具有天然的Transparency,但在Accuracy和Response Time方面表现不足,难以单独胜任风险监控;RNN形式的BBM具备较好的预测性能,却缺少满足终端用户信任要求的Explainability。所提出的GBM在Accuracy、Explainability和Computation Time之间提供了相对合理的折中,有助于满足Risk Monitoring的实际和监管要求。
5.3. Remarkable findings
研究提出基于灰箱数字孪生的Risk Monitoring方法,把Risk Metrics引入Control System,使Digital Layer与Physical Object能够在事故和紧急情况下通过反馈回路支持决策。要在实际环境部署GBDT,必须合理权衡Physics-based Model Accuracy、Trustworthiness和Computational Demand。模拟事故场景中的计算结果表明,GBM有望用于Risk Monitoring,但仍需要在更多Design-basis Accidents下检验,并研究它与Operator和Control System的交互,以确定在异常工况下是否真正适用。
其他挑战包括:把Equipment Status和Condition Monitoring Data进一步接入Risk Monitoring Module,实现Risk Profile的实时更新;解决实时数据采集、Uncertainty Quantification和Legacy System Integration问题;提升Data Management与Analytics能力,并利用AI和ML进行Data Assimilation。
与此同时,数字孪生本身也可能引入新的漏洞和意外安全风险。数字孪生用于风险评估时,其自身的可靠性、安全性与网络安全也需要被分析,而不能仅把它当作无条件可信的监控工具。 系统理论方法可在这方面发挥重要作用。
6. Natural hazards and climate change
气候变化导致自然危险的发生频率和强度上升,对工程系统和基础设施形成威胁。这一点尤其体现在NATECH(NAtural disaster triggering TECHnological accident)事故中:极端自然事件能够触发电网、供水系统和安全关键工业设施等相互依赖关键基础设施中的级联失效。例如,海平面上升、热浪和强降水均可能降低关键基础设施的Safety Margins。因此,需要数据驱动和仿真驱动风险评估框架,把未来气候变化情景纳入分析,评价Non-stationary Environmental Conditions对系统响应的影响。
气候变化预测通常由数值模型在不同人为与自然强迫条件下模拟Atmospheric Dynamics,形成Shared Socioeconomic Pathways(SSPs)等情景。Coupled Model Intercomparison Project phase 6(CMIP6)中的Global Circulation Models(GCMs)可用于估计温度变化、海平面上升及极端降水,为不断演变的基础设施风险提供输入。这些预测显示,极端降水可能加剧洪水,海平面上升可能增大海啸高度,热浪可能扩大森林火灾规模,风速和降水增强还可能加剧热带气旋。
但把这些预测纳入Probabilistic Risk Assessment(PRA)并不容易,因为Climate Model本身存在不确定性,而且还需要详细Fragility Analysis量化基础设施的脆弱性。
面向气候变化的风险评估不仅要估计自然危险本身,还必须同时描述关键基础设施的脆弱性、跨系统失效传播、扰动后的恢复过程以及长期环境变化。
本章涉及三个方向。Section 6.1介绍AI加速的Stochastic Simulation,用于分析关键能源基础设施的Resilience,并通过Rare-event Simulation处理复杂的Disruption和Recovery过程。Section 6.2将关注点从单个Hazard转向Interdependent Critical Infrastructures中的Cascading Failures,并通过DIIM及Graph-based Methods描述跨基础设施依赖。Section 6.4继续扩展到Radioactive Waste Repositories的长期Performance Assessment(PA),评价Climate Change对天然和工程安全屏障的影响。
6.1. Artificial intelligence– accelerated stochastic simulation for the risk assessment of critical energy infrastructures
关键能源基础设施(Critical Energy Infrastructures,CEIs)越来越多地受到地震、海啸等Geophysical Hazards,以及热带风暴、干旱等Meteorological Hazards的影响。气候变化可能进一步提高部分危险事件的强度和频率。2011年福岛事故、2021年得克萨斯州冰暴以及2025年加利福尼亚州野火均表明,低概率极端事件可能造成极大后果,也暴露出仅依赖常规可靠性指标进行管理的不足。
因此,System Resilience变得尤其重要。Resilience不仅意味着抵抗扰动,还包括减轻扰动后果、快速恢复,并通过运行调整提高对未来事件的适应能力。对CEI进行Resilience Assessment,需要把Natural Hazard和Climate Change Model与Cascading Failure的随机模型结合起来。
然而,这类评估往往具有高维输入、非线性相互依赖和尾部风险驱动特征,底层物理过程也很复杂,因此需要大量计算。现有框架尚不能系统解决这种Computational Challenge。
6.1.1. Proposed method: artificial intelligence and stochastic simulation for the resilience of critical infrastructure
已有CEI Resilience Quantification Framework可以是Deterministic或Probabilistic、Dynamic或Static,也可以基于Integral或Ratio构造指标。它们通常用于确定Recovery Priorities、推荐System Configuration,并辅助设计与运营分析。
但已有研究经常预先指定Disruptive Events,因此那些被认为“过于罕见”的事故场景和恢复过程可能被忽略;一些研究也会忽略System Interdependency,只对单一基础设施进行分析。这通常是因为对复杂自然危险响应进行仿真本身成本过高。
本文介绍的ARISTOTELES(ARtificial Intelligence and STOchasTic simulation for the rEsiLience of critical infrastructurES)是一个Stochastic Resilience Modeling Framework,结合Probabilistic Hazard Models、Fragility Models、Recovery Models和Dynamic Resilience Quantification Analysis。
方法首先对每一个考虑的Hazard Location抽取Intensity Measures,再根据对应的Fragility Curve计算每一个Asset的Conditional Failure Probability。确定Disruption发生后的Asset State后,按需从Recovery Distribution中抽样,形成资产随时间变化的Operational State。随后将这些State输入CEI模型,计算整个系统的Normalized Performance Curve (p_N(t)),例如能够接通的负荷所占比例。
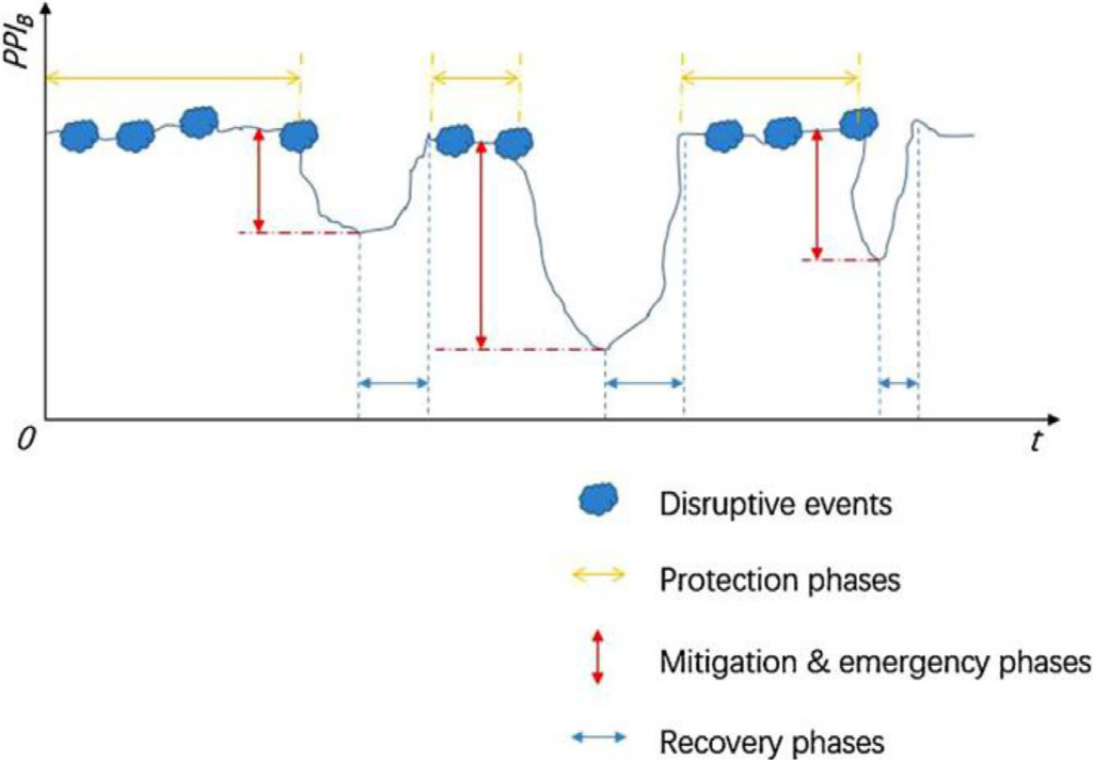
在此基础上,可以得到包含Disruption、Post-disruption和Recovery Phases的Resilience Curves。Resilience通过Recovery Period内归一化系统性能的期望值来量化:
[
R=\mathbb E!\left[\frac{\displaystyle\int_{t_0}^{t_0+T_E}p_N(t)\,dt}{T_E}\right]. \tag{3}
]
其中,(\mathbb E[\cdot])表示期望,(t_0)为Catastrophic Event的发生时刻,(T_E)为完全恢复所需的时间。系统经历扰动后,归一化性能的下降和恢复共同决定Resilience。
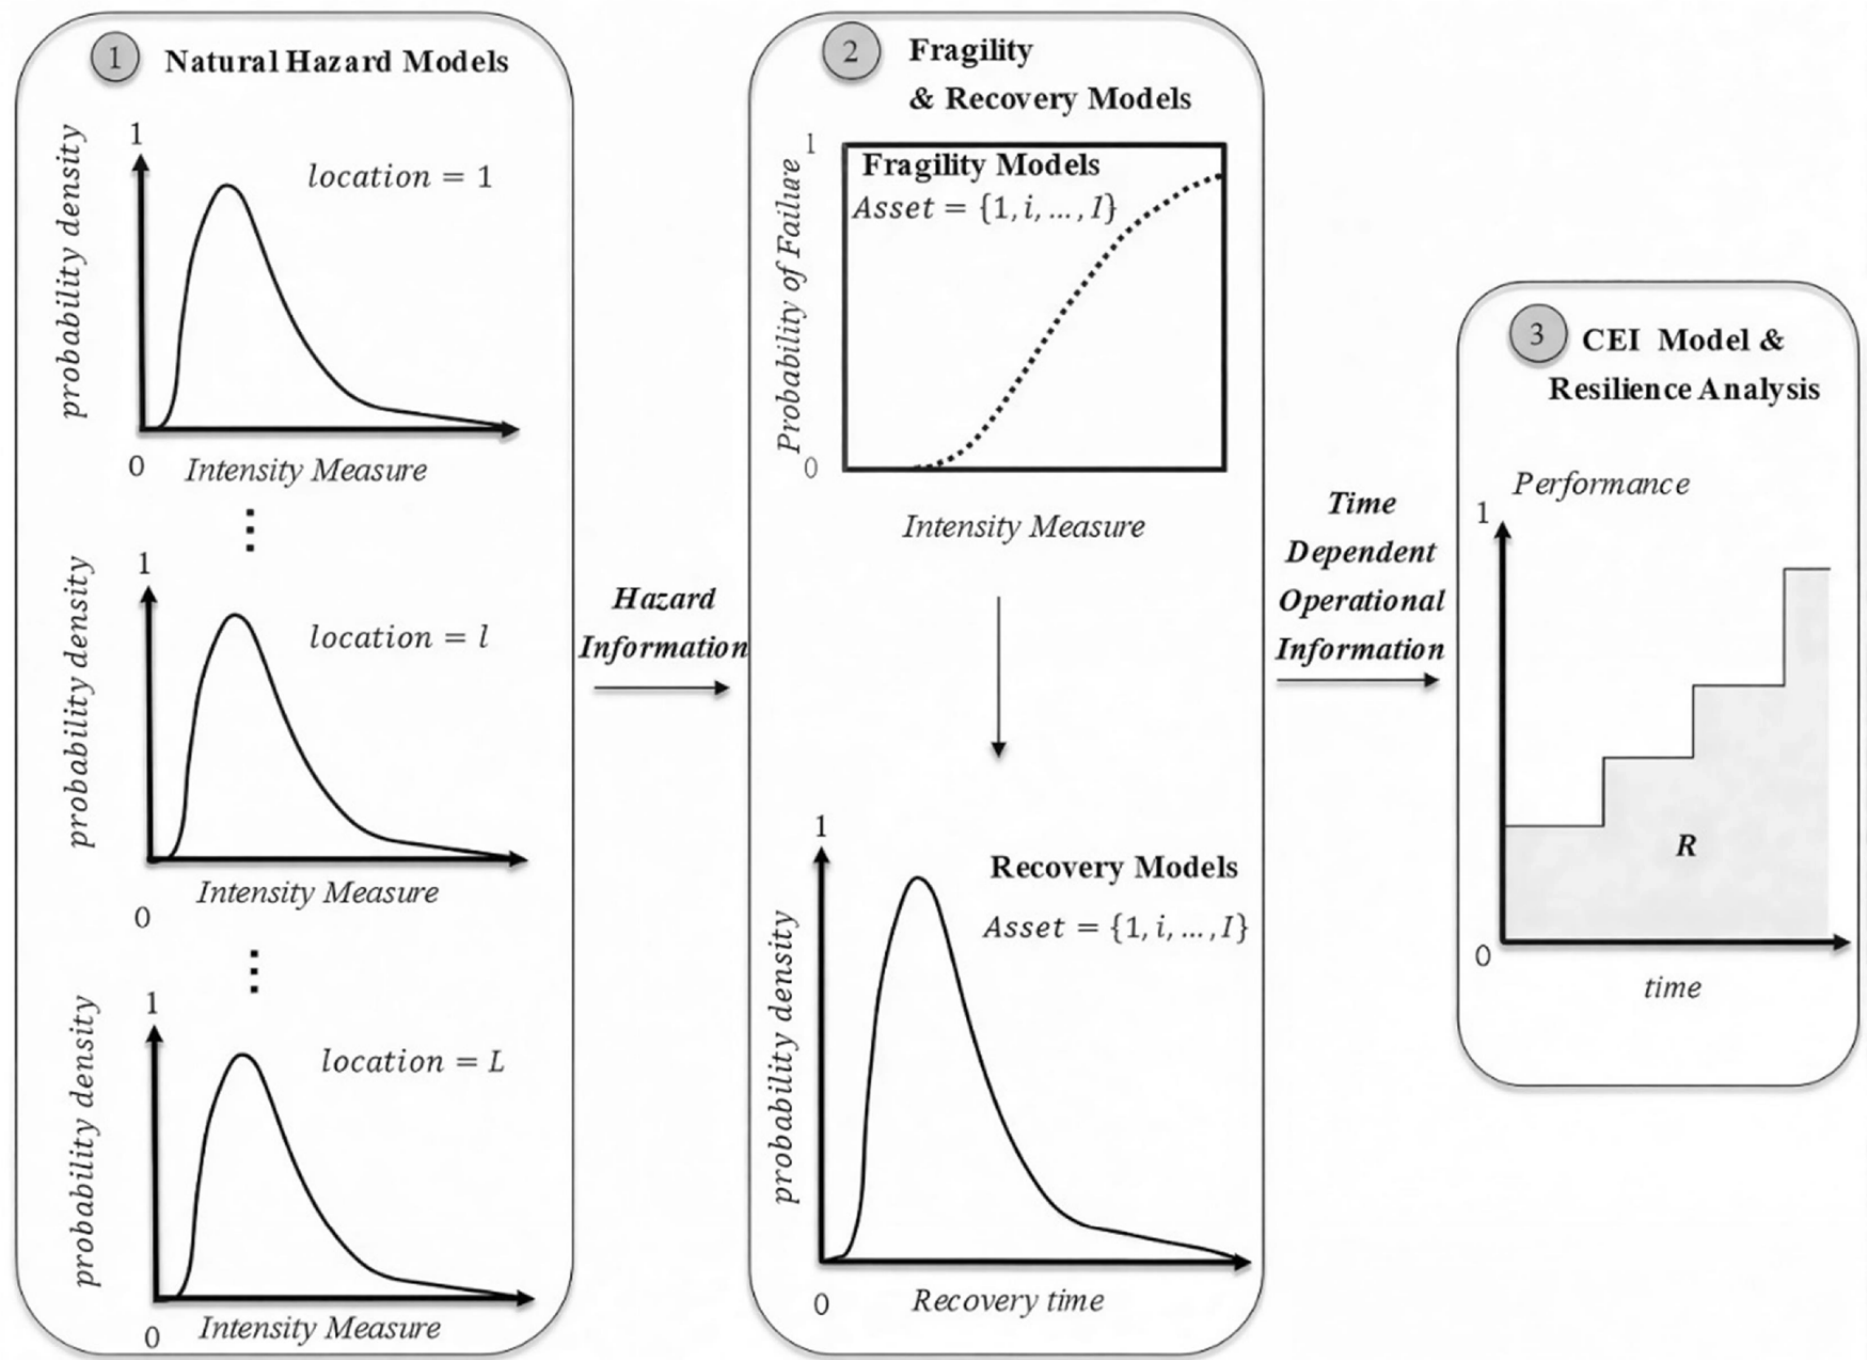
原文 Fig. 10:ARISTOTELES resilience modeling framework.
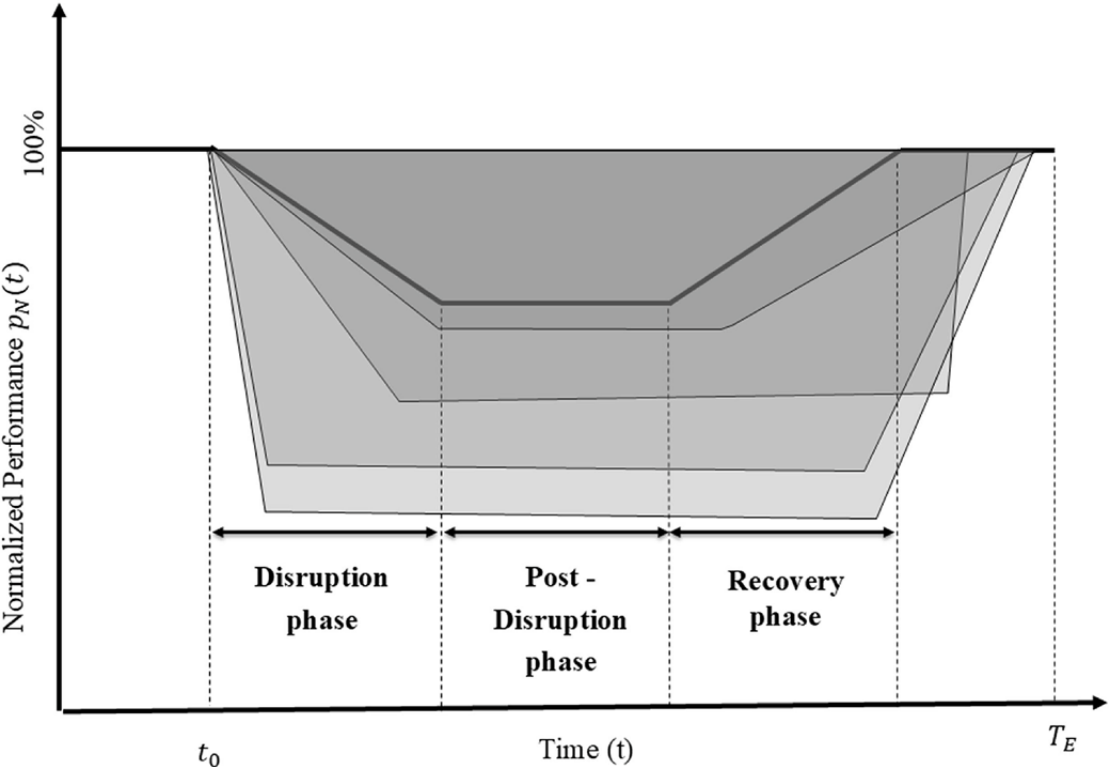
原文 Fig. 11:Conceptual resilience curve.
由于CEI模型的计算可能很昂贵,而且要探索的系统状态包含许多低概率、高影响的意外配置,因此研究引入Rare-event Simulation技术。可选方法包括Importance Sampling、Subset Simulation(SS)和Line Sampling。它们通过更有效地探索Failure Region或Failure Directions来降低估计器方差。
近年来,这些采样方法又与Surrogate Modeling结合,例如Adaptive Kriging MCS、Polynomial Chaos Kriging MCS、Adaptive Kriging-based Importance Sampling和Kriging-enhanced SS。这些方法通过Active Learning及Failure Region Refinement,降低调用高成本物理模型的次数。还可以使用Affine-invariant Markov Chain Monte Carlo(MCMC)等Sampling Algorithms,以处理高维、非线性工程问题中的复杂Probability Distributions。
在此基础上,论文首先使用Subset Simulation降低计算负担,并检验ARISTOTELES与Rare-event Sampling结合后能否更有效地探索那些通常难以观察的系统状态。
6.1.2. Case study: integrated power and natural gas system located in sicily, italy
案例采用意大利西西里岛的Integrated Power and Natural Gas System。CEI模型由Power Network与Natural Gas Network耦合组成:Power Network使用基于物理的AC Optimal Power Flow(AC-OPF),Natural Gas Network使用Weymouth Equations描述管网流动。
主要受风险影响的资产包括大型Power Stations、Gas Pipelines以及西西里岛的220 kV Transmission Lines和天然气基础设施,这些设施同时面临地震与海啸危险。模型输入包括Transmission Line Susceptance和Conductance、Pipeline Characteristics、Power Station Nominal Power以及用户Demand等物理参数。
为了求解非线性方程组,模型构建一个Optimization Function,综合考虑Generation Costs与Consumer Willingness-to-pay,并纳入Demand Price Elasticity,同时满足Power Generation、Voltage、Phase Angle和Reactive Power等约束。当系统无法满足物理约束或Demand Constraints时,应用Homogeneous Load Shedding,即反复按相同比例降低各负荷,直到系统恢复可行。
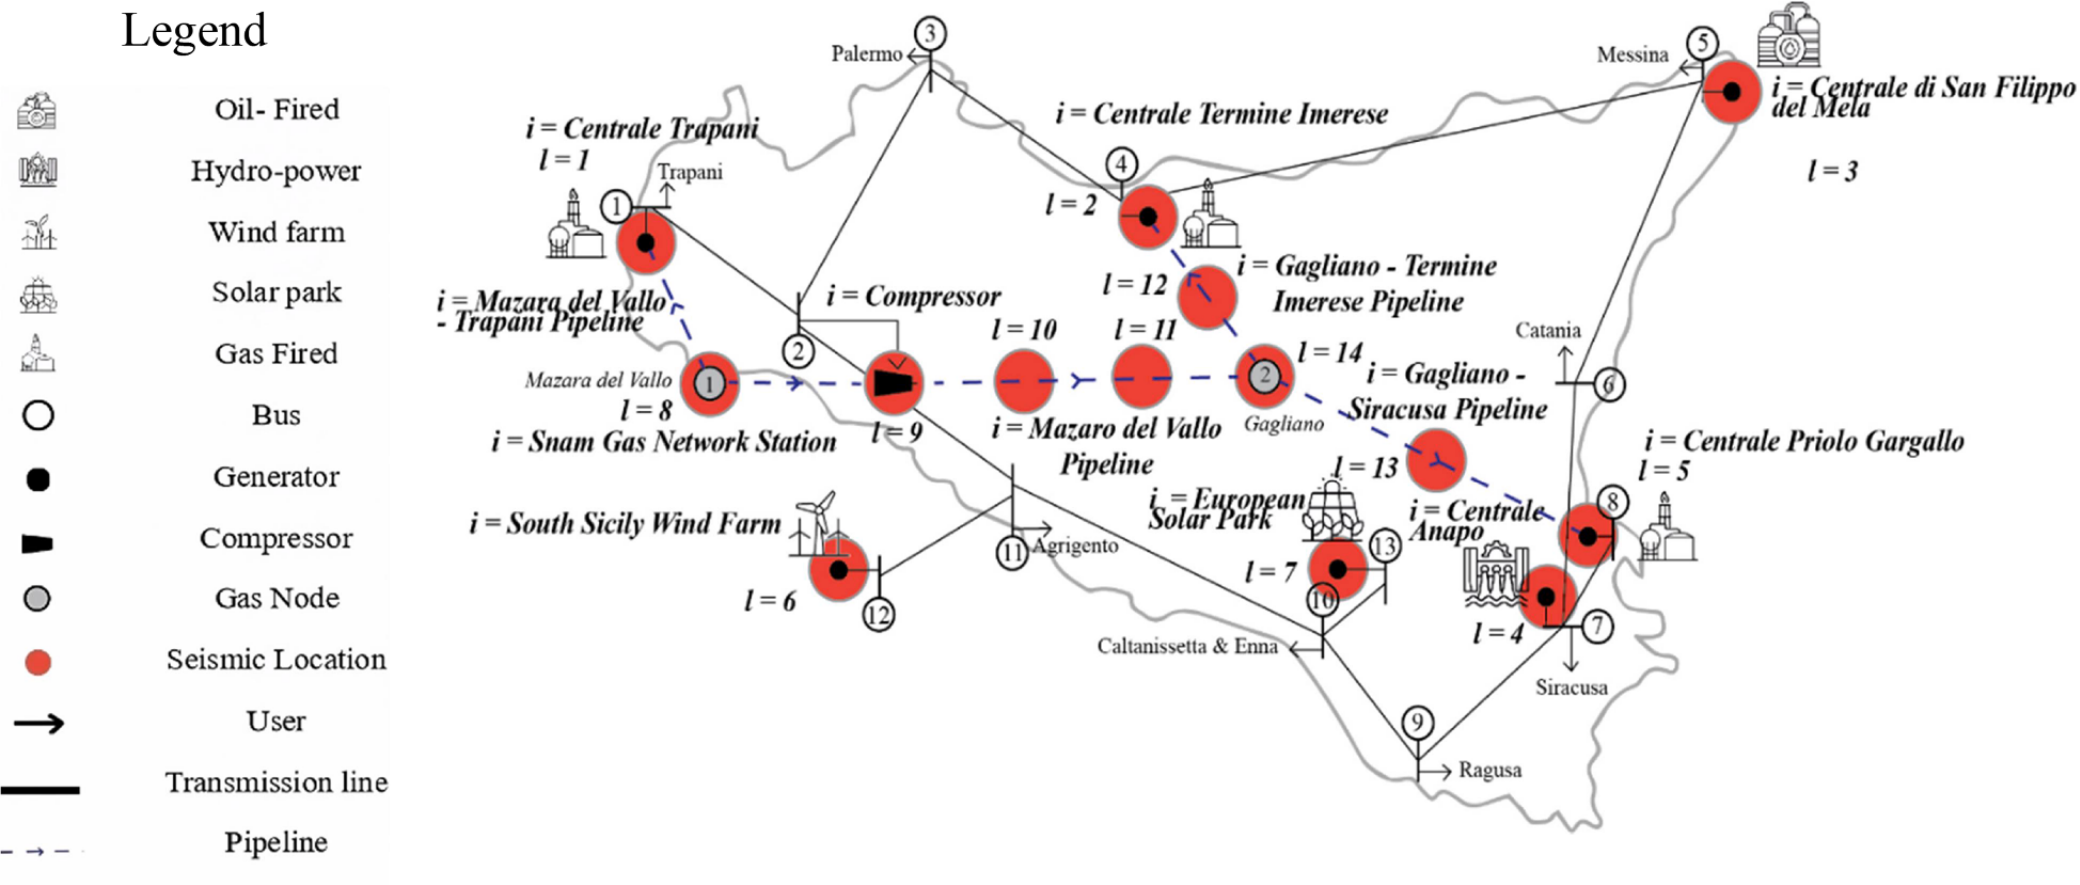
原文 Fig. 12:System Characterization: Critical Energy Infrastructure of Sicily.
Table 5比较Crude MCS和SS对Resilience的估计。评价指标包括Simulation Number (n_{sim})、在Resilience Threshold (b)下的Expected Resilience (\mathbb E[R\mid b])、Estimator Variance、采集到的Rare-event数量(N_F)、95% Confidence Interval、CPU Computation Time以及Figure of Merit(FOM)。
Table 5:在(b=0.60)条件下Crude MCS和Subset Simulation的韧性估计结果。
| 方法 | 仿真数 (n_{sim}) | (\mathbb E[R\mid b]) | 估计方差 | Rare-events数 (N_F) | 95%置信区间 | 计算时间 | FOM |
|---|---|---|---|---|---|---|---|
| Crude MCS | 100,000 | 0.5584 | (2.32\times10^{-2}) | 19 | (\pm1.07\times10^{-2}) | 6 min | 3.17 |
| SS | (4\times25,000) | 0.5705 | (2.91\times10^{-2}) | 8,722 | (\pm6.23\times10^{-4}) | 18 min | 484.7 |
原文的FOM以所发现的Rare-event数量和CPU Time为依据,用于衡量低概率、高后果事件探索效率与计算成本之间的关系。Figure 13显示在一次SS运行中,Unconditional Distribution(B0)与不同Conditional Levels(B1、B2、B3)的Empirical Histograms。B0对应一般MCS;后续Conditional Levels由Metropolis–Hastings MCMC产生。随着条件层级提高,样本分布逐渐向Resilience Threshold (b=0.60)的区域移动,探索发生概率约为(10^{-4})的低概率状态。
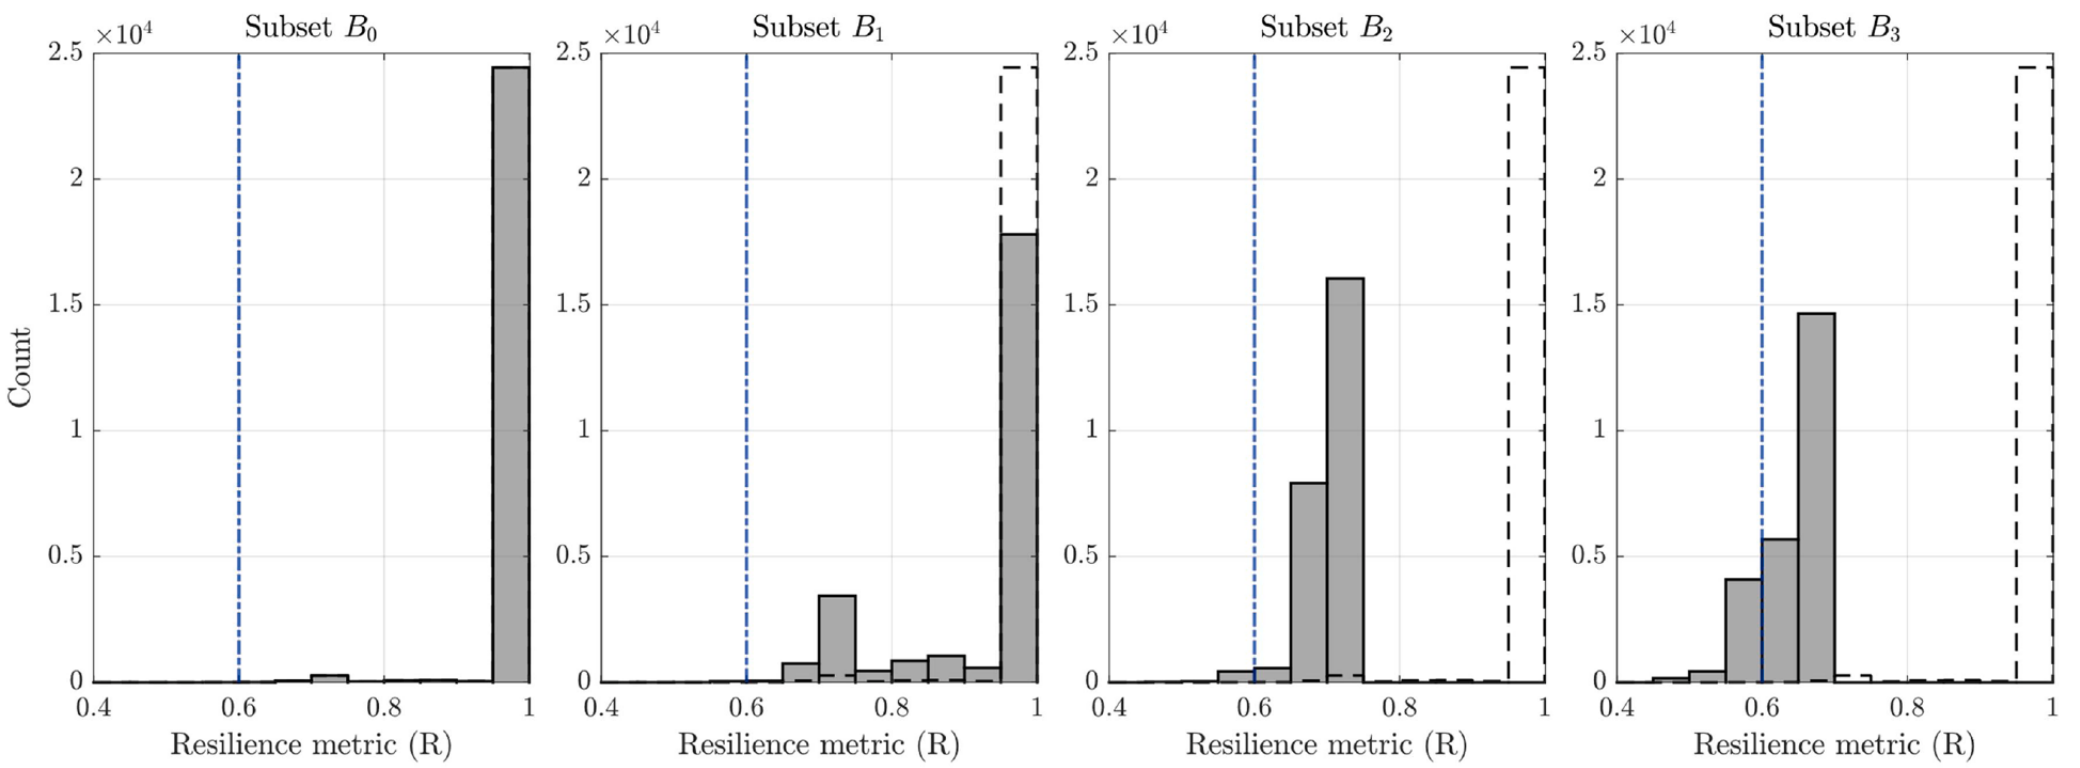
原文 Fig. 13:Empirical conditional distributions of the resilience metric at different conditional levels.
为了公平比较,两种方法采用相同数量级的Simulation Evaluations。结果表明,SS的FOM约为Crude MCS的150倍,而且95% Confidence Interval明显更窄,因此得到更高的Estimation Precision。虽然SS结果的Estimator Variance略大,但其发现的Rare-events数量要多得多,因而为后续Importance Analysis及其他Resilience Post-processing提供了更多信息。
Subset Simulation的优势并不是单纯减少一次仿真的运行时间,而是在相近的模型调用成本下,显著提高罕见失效场景的发现数量和风险估计精度。
6.1.3. Remarkable findings
ARISTOTELES集成Rare-event Simulation、Natural Hazard Models、Fragility Models、Recovery Models和Resilience Analysis,为预先评估关键基础设施韧性、探索可能的预防措施提供一套框架。对于暴露在极端自然危险下的CEI,Subset Simulation尤其有用,因为问题通常具有高维、非线性Failure Domain。
但框架目前尚未完整推广到同时发生的Multiple Hazards,例如地震引发的海啸、余震,以及海平面上升对地震诱发海啸危险的影响。Stochastic Simulator还可能产生Noisy Output和高维输入下退化的Probability Distributions。此外,若要可靠地推荐韧性改进措施,还需要进一步提高模型精细度,包括Multi-modal Fragility Models、Time-varying Energy Demands和不同Hazard Inputs之间的Spatial Correlations;这些改进会增加计算成本。
未来研究包括将框架推广到Multi-hazard与Climate Change条件,使用Adaptive Kriging、Affine-invariant MCMC等方法进一步降低计算负担和Estimator Variance,以及开发对模拟Resilience Trajectories进行Post-processing的方法,为Mitigation、Recovery和Resilience-oriented Design Improvements提供支持。
6.2. Modeling cascading failures in interdependent CIs exposed to CC
由于Interdependencies能够放大系统失效,研究人员已经提出多类关键基础设施互依建模方法,主要分为Holistic和Reductionist两类。Holistic Approach把各基础设施作为整体系统,描述System-wide Dynamic Interactions;Reductionist Approach则关注单个基础设施或其Subsystems,详细分析局部Failure Mechanisms和Interdependencies。
Reductionist Model有利于优化具体Infrastructure Design和Operational Safety,但可能忽略造成大型系统失效的更广泛Systemic Interactions。Holistic System Dynamics Model能够描述长期Disruption Propagation,却常使用高度聚合的表示形式,需要较多Calibration,难以反映气候驱动危险对不同基础设施造成的异质影响。
基于数据的Dependency Estimation可以利用真实Operational Data,但高分辨率Failure和Dependency Observations往往不足,特别是在承受气候应力的相互依赖基础设施中。另一方面,Agent-based Models和Discrete-event Simulation可以详细表示Component-level Interactions,却依赖细粒度拓扑及运行数据;在大规模、长期气候扰动问题中,这类模型的计算成本可能难以承受。
因此,已有方法往往要么使用Static或Lumped Representation过度简化Interdependencies,要么需要现实中难以获得的详细数据,从而形成一个尚未解决的问题:如何在气候变化条件下,以具有可扩展性的方式描述State-dependent Cascading Failures。
Dynamic Inoperability Input–Output Model(DIIM)属于Holistic Method,能够从System-wide Perspective描述Failure Propagation和高阶Dependency。它在传统Inoperability Input–Output Model中增加Temporal Dimension,从而分析Disruption Evolution与System Recovery。
Inoperability定义为因Disruption造成的Lost Functionality占计划Operational Capacity的比例,用于衡量关键基础设施无法提供预定服务或产品的程度。在Risk Analysis中,这相当于Disruptive Scenario的Consequence,而Disruption Magnitude又受到CIs之间Interdependencies及Cascading Effects的影响。
DIIM的核心难题之一是确定Interdependency Matrix (\mathbf A),也就是如何量化一个基础设施的损伤对其他基础设施的传播作用。DIIM能够描述System-wide Cascades,但其Infrastructure-level Representation本质上是聚合的,难以分析某一个基础设施内部特定Node或Connection失效后形成的复杂局部传播路径。
Graph Theory能够弥补这一不足。它把每个CI表示为Nodes(Components)和Edges(Connections)组成的网络,从而描述更细粒度的Internal Topology。因此,通过DIIM表征跨基础设施的宏观依赖,再通过Graph Theory刻画各基础设施内部的局部结构脆弱性,可以更完整地分析气候危险驱动的级联失效。
6.3. Proposed method: stochastic modeling of interdependencies in multi-state CIs
Figure 14所示方法用于估计Interdependency Matrix (\mathbf A)中具有随机性和状态依赖性的Coefficients。具体数学推导和实现方法在作者前期研究中给出。
由于相互依赖CIs中的Failure可以沿不同Pathways传播,必须分析多个Failure Scenarios才能描述Cascading与Escalating Effects。方法首先表征每个CI:从Holistic Representation转到Graph-based Representation,以评估Intra-system Dependencies。系统之系统中的每个CI都被表示为Graph,Nodes代表Substations、Reservoirs等Components,Edges代表Power Lines、Pipelines等Connections。
接着分析SoSs之间的Interdependencies。考虑一个一般关系(i\rightarrow j),表示第(j)个CI依赖第(i)个CI。首先识别两个基础设施之间存在直接连接的Node Subsets,再构造State Dependency Matrix (\mathbf M_{i\to j}),描述第(i)个CI的Node States变化如何影响第(j)个CI中直接连接Nodes的状态。
不同CI中的Nodes可以具有多个States,例如Fully Operational、Partially Functional或Inoperative。因此,这一步的重点是确定第(i)个CI发生State Transition时,如何改变第(j)个CI的State Evolution。
完成Dependency Mapping后,在第(i)个CI中施加Disruptions,并根据(\mathbf M_{i\to j})定义的关系模拟Cascading Effects。记录两个CIs在不同场景下的Inoperability,同时纳入依赖关系造成的附加影响。重复大量Failure Scenarios以后,可以建立Conditional Probability Matrix (\mathbf R_{i\to j}),其元素表示:已知受扰动CI (i)处于矩阵某一行对应的状态,依赖CI (j)进入某一列对应状态的条件概率。
最后,利用Probabilistic Weighting估计Interdependency Coefficient (a_{ji})。对于(\mathbf R_{i\to j})的每一行,把每个Conditional Probability与CI (j)相应Discrete Inoperability State的上界相乘,再求和。由此使传统DIIM中固定的(a_{ji})转换成一个随CI (i)当前Discrete State变化的系数。
这种可变Interdependency Coefficient能够同时反映失效传播的可能性与后果强度,避免假设一个基础设施的不可运行程度始终会对另一个基础设施产生固定比例的影响。
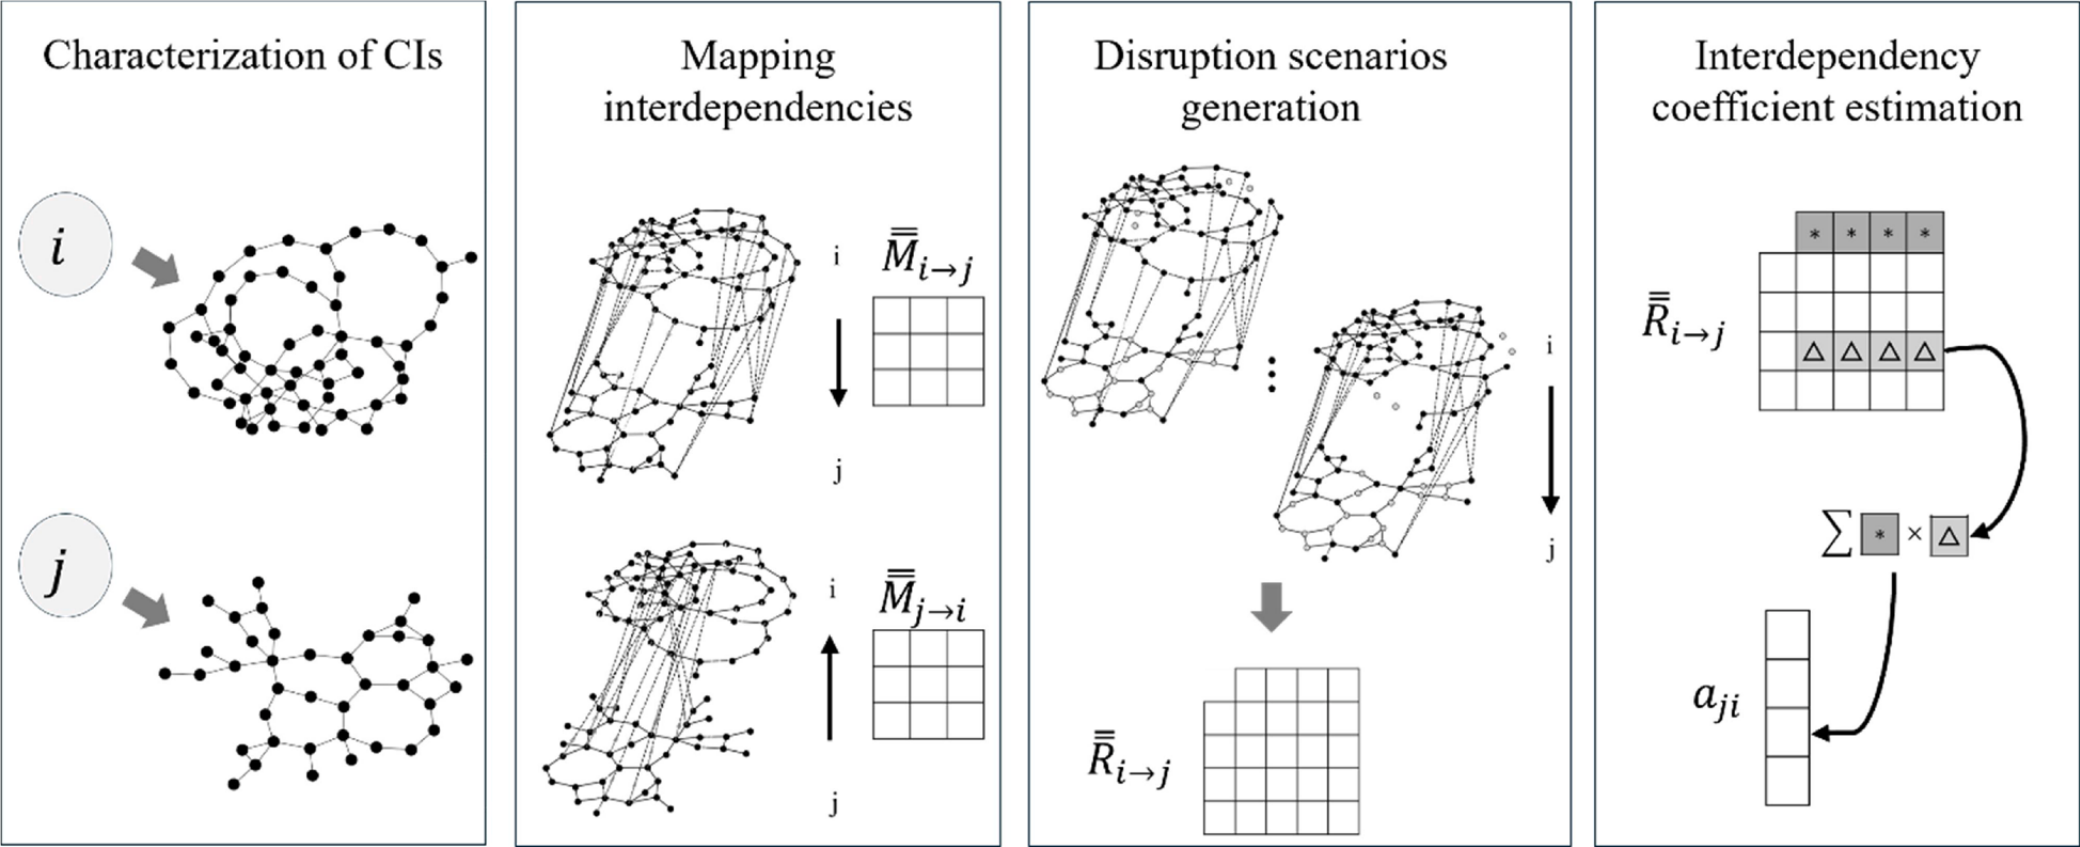
原文 Fig. 14:Methodology for stochastic interdependency coefficients.
6.3.1. Case study: interdependent power and water networks
案例构建一个由Water Network(WNet)和Power Network(PNet)组成的SoSs。PNet的Supplier Nodes依靠WNet提供Cooling Water,而WNet则依靠Power Supply完成Pumping Operations,因此二者存在双向依赖。
PNet采用IEEE 57-bus Test System,WNet拓扑则改编自IEEE 39-bus System。两个网络中的Nodes均被分为Supplier Nodes和Demand Nodes,以明确其功能角色。通过为每个Supplier赋予Nominal Production Capacity、为每个Demand Node赋予Nominal Consumption,并统一乘以比例系数(\alpha=0.05),获得适合Topological Operability Analysis的Supply–Demand数据。
Node的Operational State取决于是否仍连接到可用Supplier、可获得多少供给,以及其Connected Component中剩余的Generation Capacity。研究通过随机删除一定比例的Nodes引入Disruption,删除比例从([0,1])中的Uniform Distribution抽取。Node失效后,其Incident Edges也被删除,因此网络可能发生Fragmentation。
Cross-infrastructure Dependencies通过预先定义的Power–Water Supplier–Consumer Mapping实现。只有当依赖Node所需的全部对侧供应节点都失效时,该Node才被判定为Non-operational,与考虑Redundancy的Propagation Rule一致。待Intra-CI和Inter-CI的Failure Propagation稳定后,根据Connectivity、Satisfied Demand和Operational Supply计算Inoperability。
两个网络中的Supplier Nodes有四种States:Fully Operational;由于Edge Failure而Disconnected;Overloaded;因Climate Change Event直接影响而Inoperable。Demand Nodes则有三种States:Fully Operational;因Supplier Loss而Disconnected;因Climate Hazard直接影响而Inoperable。
两个网络之间设置Redundant Dependencies:WNet中每个Supplier Node依赖PNet的两个特定Nodes,而PNet中每个Supplier Node则依赖WNet的两个Demand Nodes。Figure 15展示两个网络内部的Commodity Flows及Power-to-Water、Water-to-Power依赖关系。
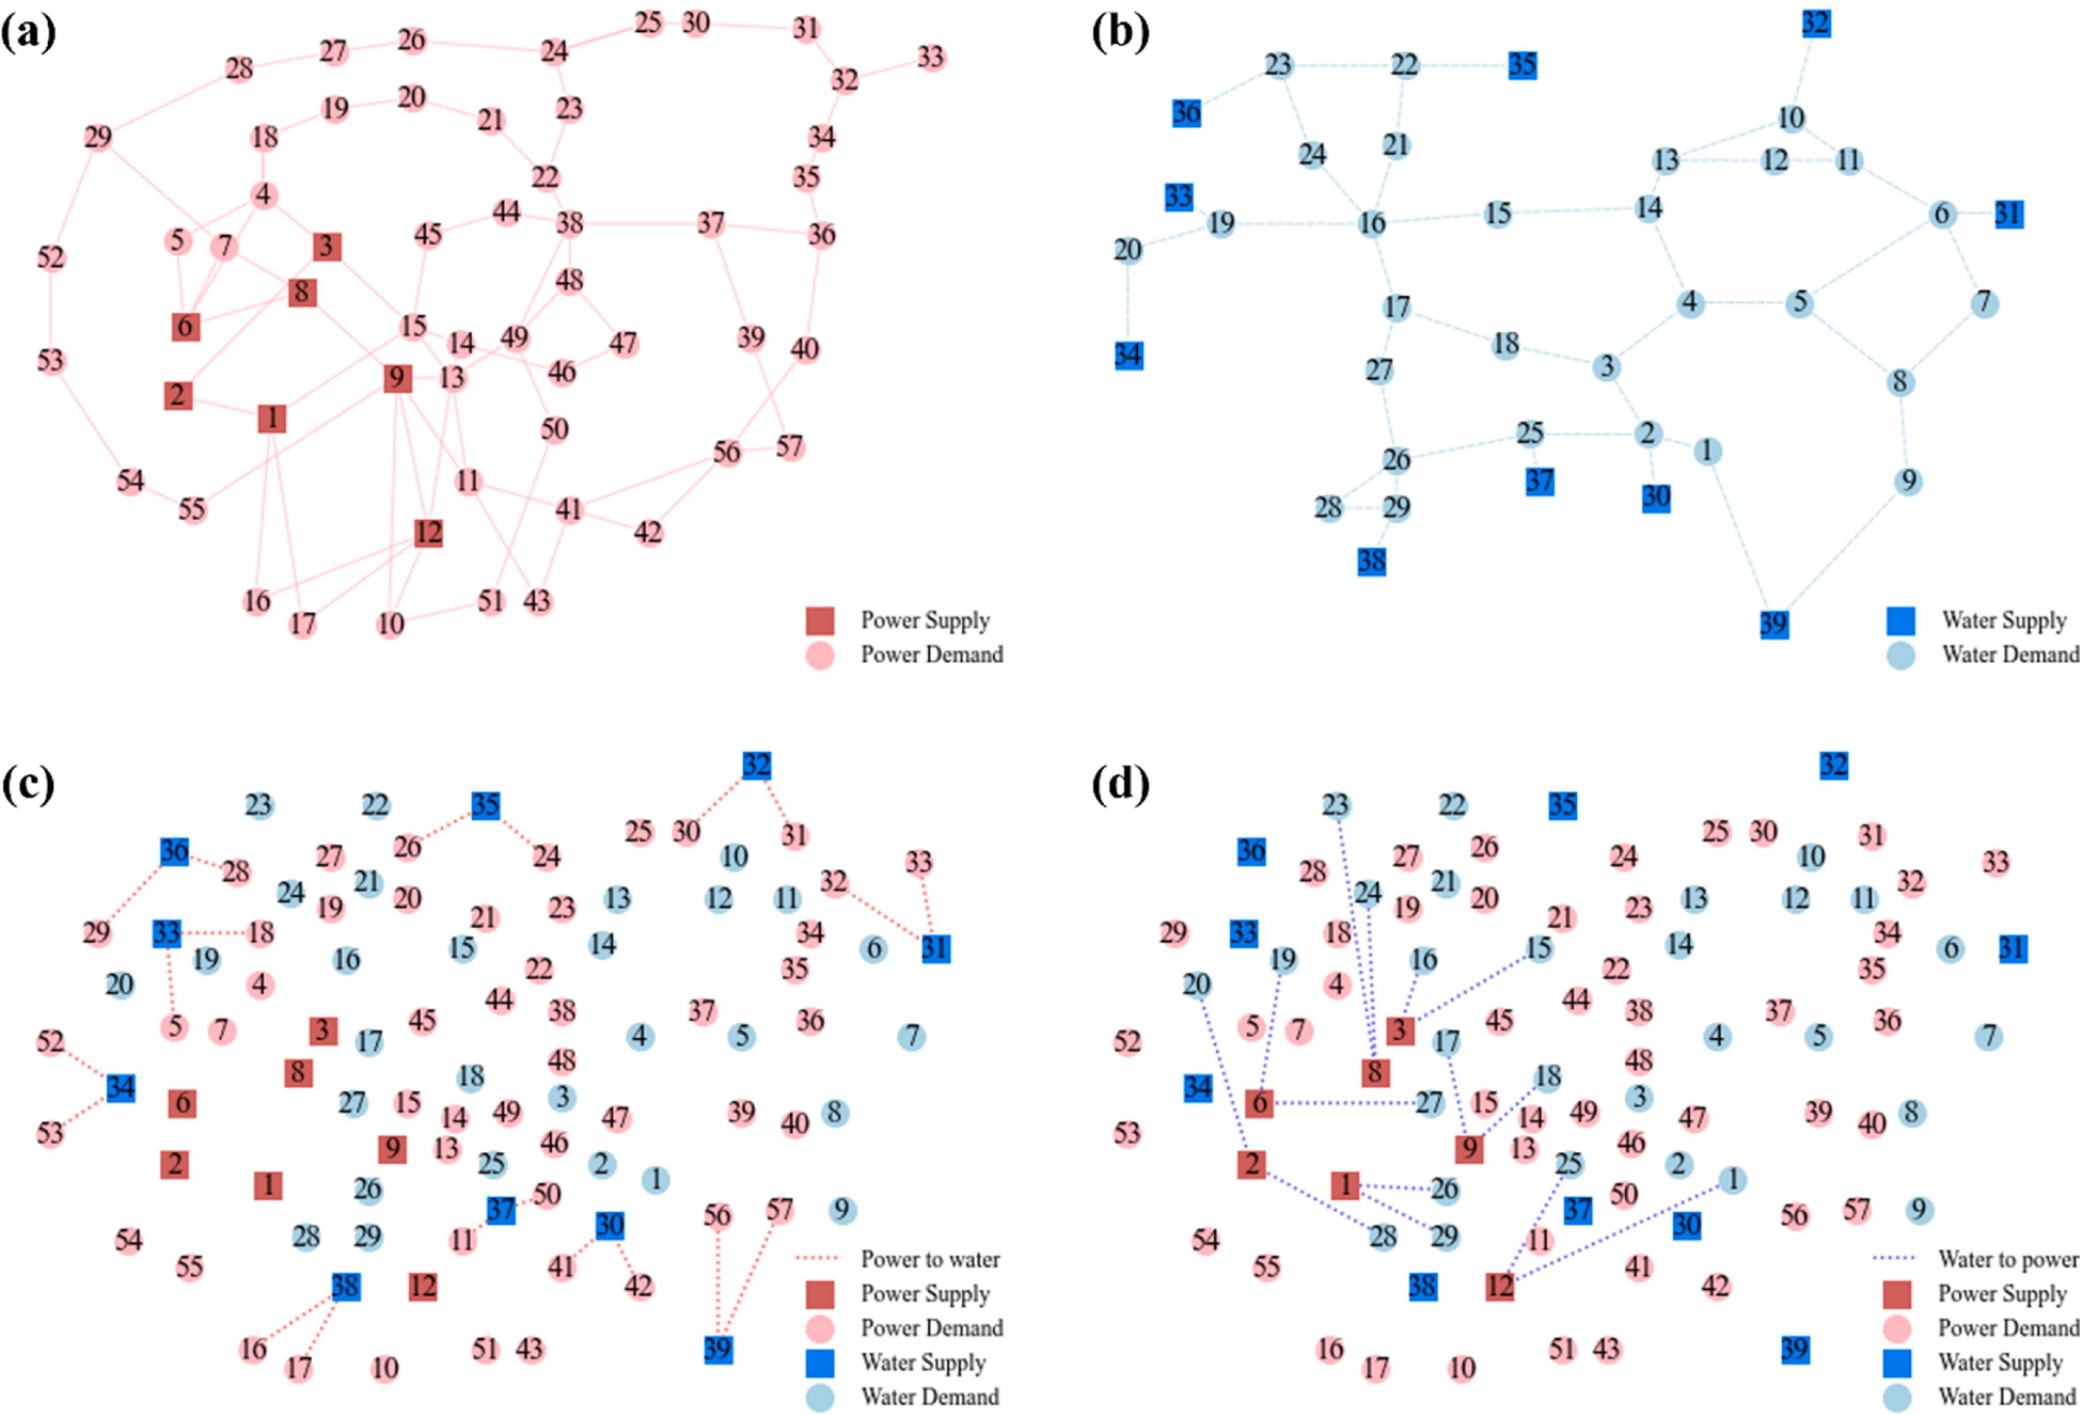
原文 Fig. 15:SoSs under study: internal and cross-infrastructure flows in PNet and WNet.
为评估Climate-induced Disruptions,研究对PNet和WNet各进行1000次模拟。每个Scenario都模拟局部Hazard Event直接影响Infrastructure Nodes。对PNet而言,失效模拟洪水淹没Substations;对WNet而言,失效模拟洪水损坏Pumping Substations。
完成模拟后,形成(\mathbf R_{\mathrm{PNet}\to\mathrm{WNet}})和(\mathbf R_{\mathrm{WNet}\to\mathrm{PNet}})两个Conditional Probability Matrices。根据矩阵中不同Inoperability State的概率及各区间上界,估计不同损伤水平下的Cross-infrastructure Coefficients。
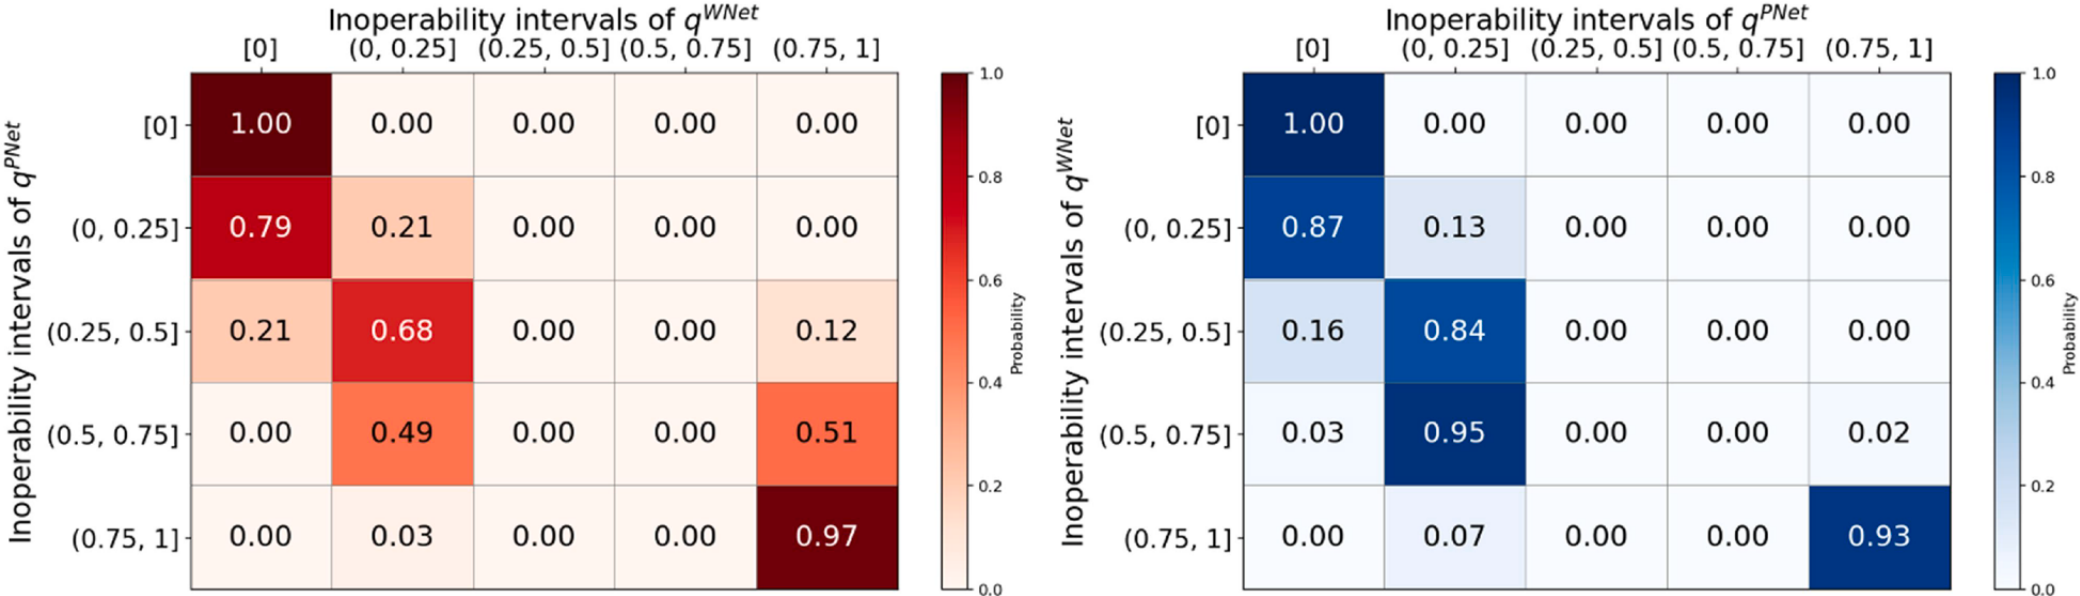
原文 Fig. 16:Conditional probability matrices derived from disruption scenarios.
Figure 17考察当一个CI初始Inoperability为50%,并假定两个CI都在15天内恢复时,双方Inoperability如何随时间演化。结果表明,PNet最先受扰动通常会对WNet产生更强的Cascading Effect;相比之下,WNet最先受扰动对PNet的Secondary Impact较小。这种Asymmetry反映了两个网络的依赖结构:WNet对PNet的运行连续性具有更强依赖。
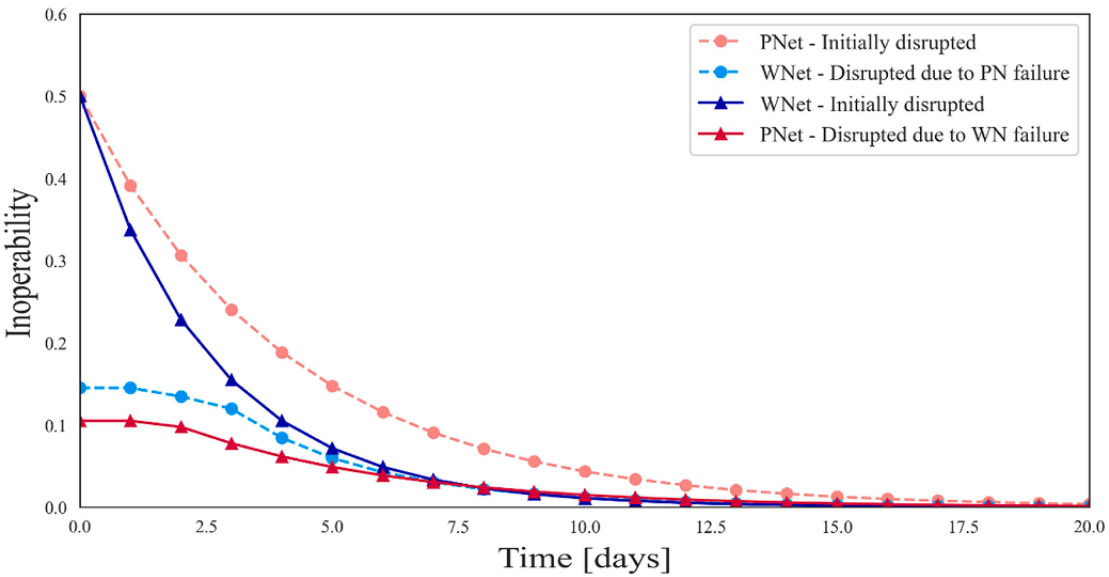
原文 Fig. 17:Inoperability evolution of CIs when the other is initially disrupted at 50% inoperability.
6.3.2. Remarkable findings
将Stochastic Failure Propagation纳入Interdependency Modeling后,框架能够为相互依赖CIs提供基于仿真信息的风险评估,帮助制定面向Climate-induced Disruption的Resilience Plans。它能够估计在不同Failure Conditions下,一个CI中的Disruption如何传播到另一个CI,并使Dependency Coefficients随系统状态动态变化。
对不同Scenario进行的分析还显示,虽然Failure Locations不同、Nodes承担不同功能,Cascading-failure Response与Initial Disruption Magnitude仍表现出较强相关性。研究得到PNet的Correlation Coefficient (\rho=0.84),WNet的(\rho=0.80)。这说明在不同Hazard Realizations下,所提出的Framework可以产生较稳定、可解释的System Response。
未来需要更加真实的Hazard Modeling,以生成能够反映受损Nodes之间Spatial Dependencies的Disruption Scenarios。当前以Random Node Removal表示Hazard Impact,没有显式模拟空间相关的Flood Intensity或真实Physical Exposure。CIs之间的依赖关系也在模型中预先固定,但实际系统可能具有Time-varying或Load-dependent Dependencies。此外,方法向更大规模和异质性更强的CIs扩展时仍需考虑Computational Scalability。可以采用Screening或Minimal Inoperability Sets等技术,减少需要显式分析的Failure Combinations。
本案例主要分析Disruption和Degradation阶段,而没有进一步模拟Recovery或Repair过程。未来可将其与更详细的Physics-based或Data-driven Models结合,使风险和韧性评估更加完整。
6.4. Performance assessment of radioactive waste repositories under CC
为了评估Radioactive Waste Repositories释放的Radionuclides导致Groundwater Contamination的风险,研究人员已经建立了Performance Assessment(PA)框架。典型PA包含四项工作:识别可能破坏Safety Barriers完整性的Scenarios;估计这些Scenarios的Occurrence Probabilities;估计Radionuclide Release造成的后果,通常以预先定义的Critical Population Group接受的Expected Dose表示;以及评估上述估计结果中的Uncertainties。
放射性废物处置设施对Radionuclides的环境阻隔通常由多种Safety Barriers共同承担。Natural Attenuation包括Sorption、Biodegradation、Dilution和Dispersion;Engineering Barriers包括Containment Structures和Drainage Systems;Geological Barriers主要指自然形成的Low-permeability Soil Layers;还可以通过Pump-and-treatment、Topsoil Capping、Flow Barriers等Remedial Actions降低污染物扩散。
Climate Change对Natural Attenuation和Engineering Barriers都可能产生重要影响,因为Radionuclide Migration Process的时间尺度与Climate-induced Environmental Modification的时间尺度存在可比性。不同Safety Barrier对Dose Intake Reduction的作用,严格依赖PA所采用的Time Horizon。
例如,低中放近地表处置设施的PA通常覆盖(10^2)到(10^4)年,因此近期气候变化就可能影响Engineering Barrier Performance。对于高放废物深地质处置库,PA往往需要考虑(10^4)到(10^6)年的Radionuclide Migration,此时长期Climate Change对Natural Attenuation和Geological Barriers的影响更加突出。
Climate Change会改变Evapotranspiration和Precipitation等主要Hydrological Variables,从而影响Groundwater Recharge、极端降水频率和强度,以及Subsurface Flow Paths。Aquifer Climatic Boundary Conditions(CBCs)的变化可能降低Sorption和Dispersion等Natural Attenuation Processes的有效性,进而影响污染物Migration和Maximum Dose Intake。
为分析这种影响,需要在Non-stationary CBCs条件下计算Groundwater Contaminant Transport。Stochastic Weather Generator(SWG)等Downscaling方法可将GCM中空间、时间分辨率较粗的Climate Projections转换成污染场地风险评估所需的较精细边界条件。
针对Engineering Barriers,混凝土可能因Climate Change影响而加速两类Chemical Degradation:Carbonation-induced Corrosion和Chloride Ingress。二者都与Temperature、Relative Humidity及CO₂浓度等Climate Factors有关。因此,研究进一步使用DBN评估不断变化的Climate Conditions对Concrete Degradation的影响。
放射性废物处置设施的长期安全评估需要把随时间变化的气候边界条件与工程屏障、天然阻隔和放射性核素迁移过程连接起来,而不能把环境条件视为永久不变。
6.4.1. Proposed method: dynamic Bayesian network (DBN) for embedding CC in PA
Bayesian Network(BN)此前已经用于Nuclear Waste Repositories的PA。在这类网络中,Nodes表示Features、Events and Processes(FEPs),例如Natural Barriers、Engineering Barriers、Chemical Degradation及目标变量Dose Intake;Directed Edges表示其Causal Dependencies。
与Static BN不同,Dynamic Bayesian Network可以表示Temporal Processes和Time-evolving Dependencies,因此适合把Climate Change带来的影响纳入Chemical Degradation Modeling。研究将Carbonation和Chloride Nodes通过Temporal Arcs连接起来,使Concrete Degradation在不同时间点上的状态能够逐步演化。随后,Chemical Degradation这一FEP可以从DBN中得到输入,以动态刻画Climate Variables变化引起的Chemical Corrosion。
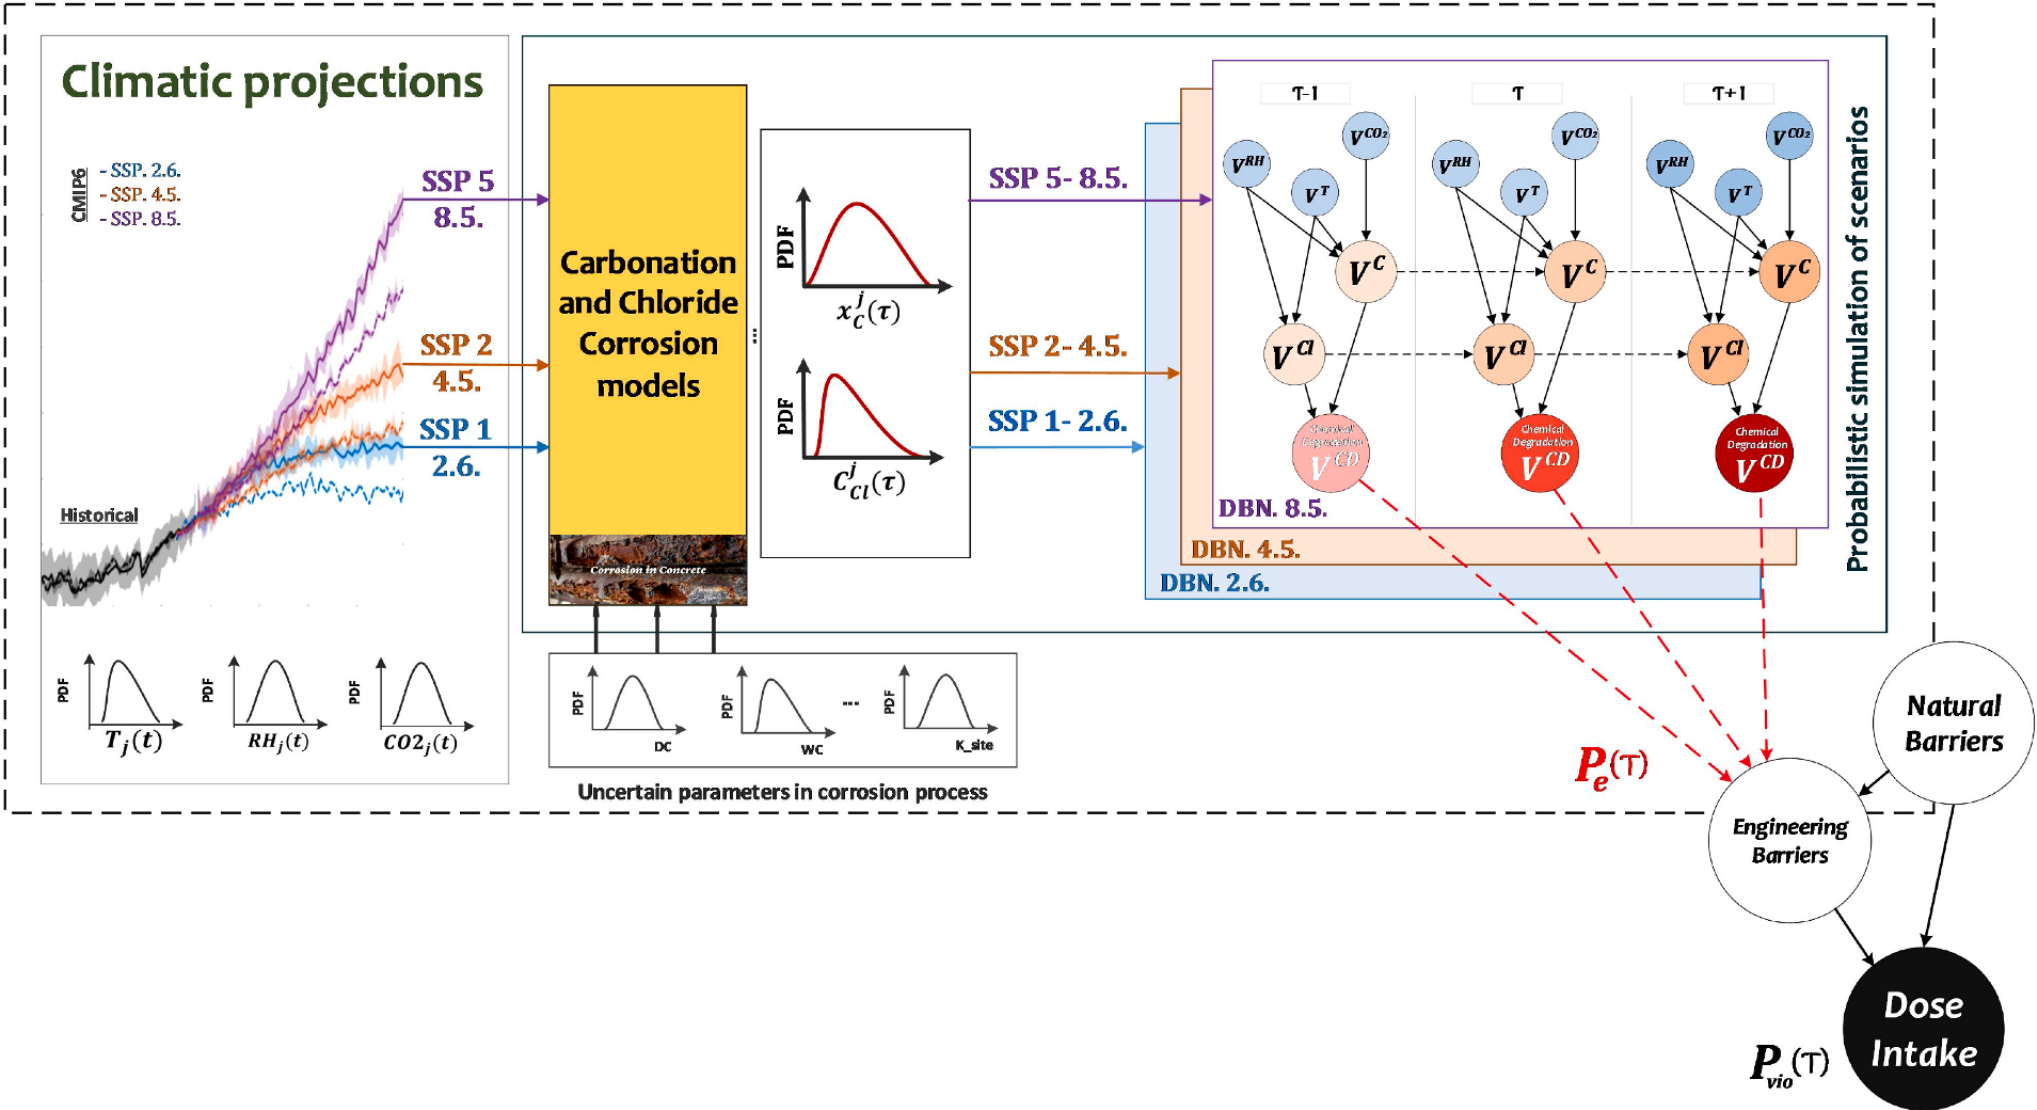
原文 Fig. 18:DBN-based framework for embedding climate-change effects in the chemical degradation of concrete barriers.
DBN中的每个Node都需要Conditional Probability Tables(CPTs)。这些CPTs可以从Simulation Data中学习,也可以由Expert Judgment给定。与气候相关的Nodes,例如Temperature、Relative Humidity和CO₂ Concentration,可以使用CMIP6等Climate Projection Datasets。对于Concrete等工程屏障的Time-dependent Degradation Nodes,则可以使用Physical Degradation Models生成的Simulation Datasets。
这种方法能够把不同来源的数据与Model Knowledge集成到统一Probabilistic Graph中,持续估计长时间尺度下的工程安全屏障状态和最终Dose Intake Risk。
6.4.2. Case study: risk of dose intake violation over alternative CC projections
案例为比利时Dessel的一座Near-surface Radioactive Waste Disposal Facility。该设施包含多种Engineering Barriers和Natural Barriers,用于限制Radionuclide Migration。
DBN采用九个离散Time Slices,时间间隔为(\Delta t=10)年,从2020年((\tau=0))到2100年((\tau=8))。模型包含3个Climate Change Variables、2个由Simulation描述的FEPs和8个基于Expert Knowledge的FEPs,共117个DBN Nodes。
Carbonation和Chloride Ingress是两个由模型模拟的Nodes,并考虑不确定的Physical Parameters及Boundary Conditions。最终目标Node为Dose Intake,对应的Regulatory Threshold为:
[
\text{Dose Intake}<1\ \mathrm{mSv/year}.
]
论文在2030年至2100年的多个Time Intervals上估计Dose Intake超过Regulatory Threshold的Probability,并比较三种IPCC SSP Climate Projections:SSP1–2.6、SSP2–4.5和SSP5–8.5,分别代表低、中和极高温室气体排放路径及其不同升温情景。
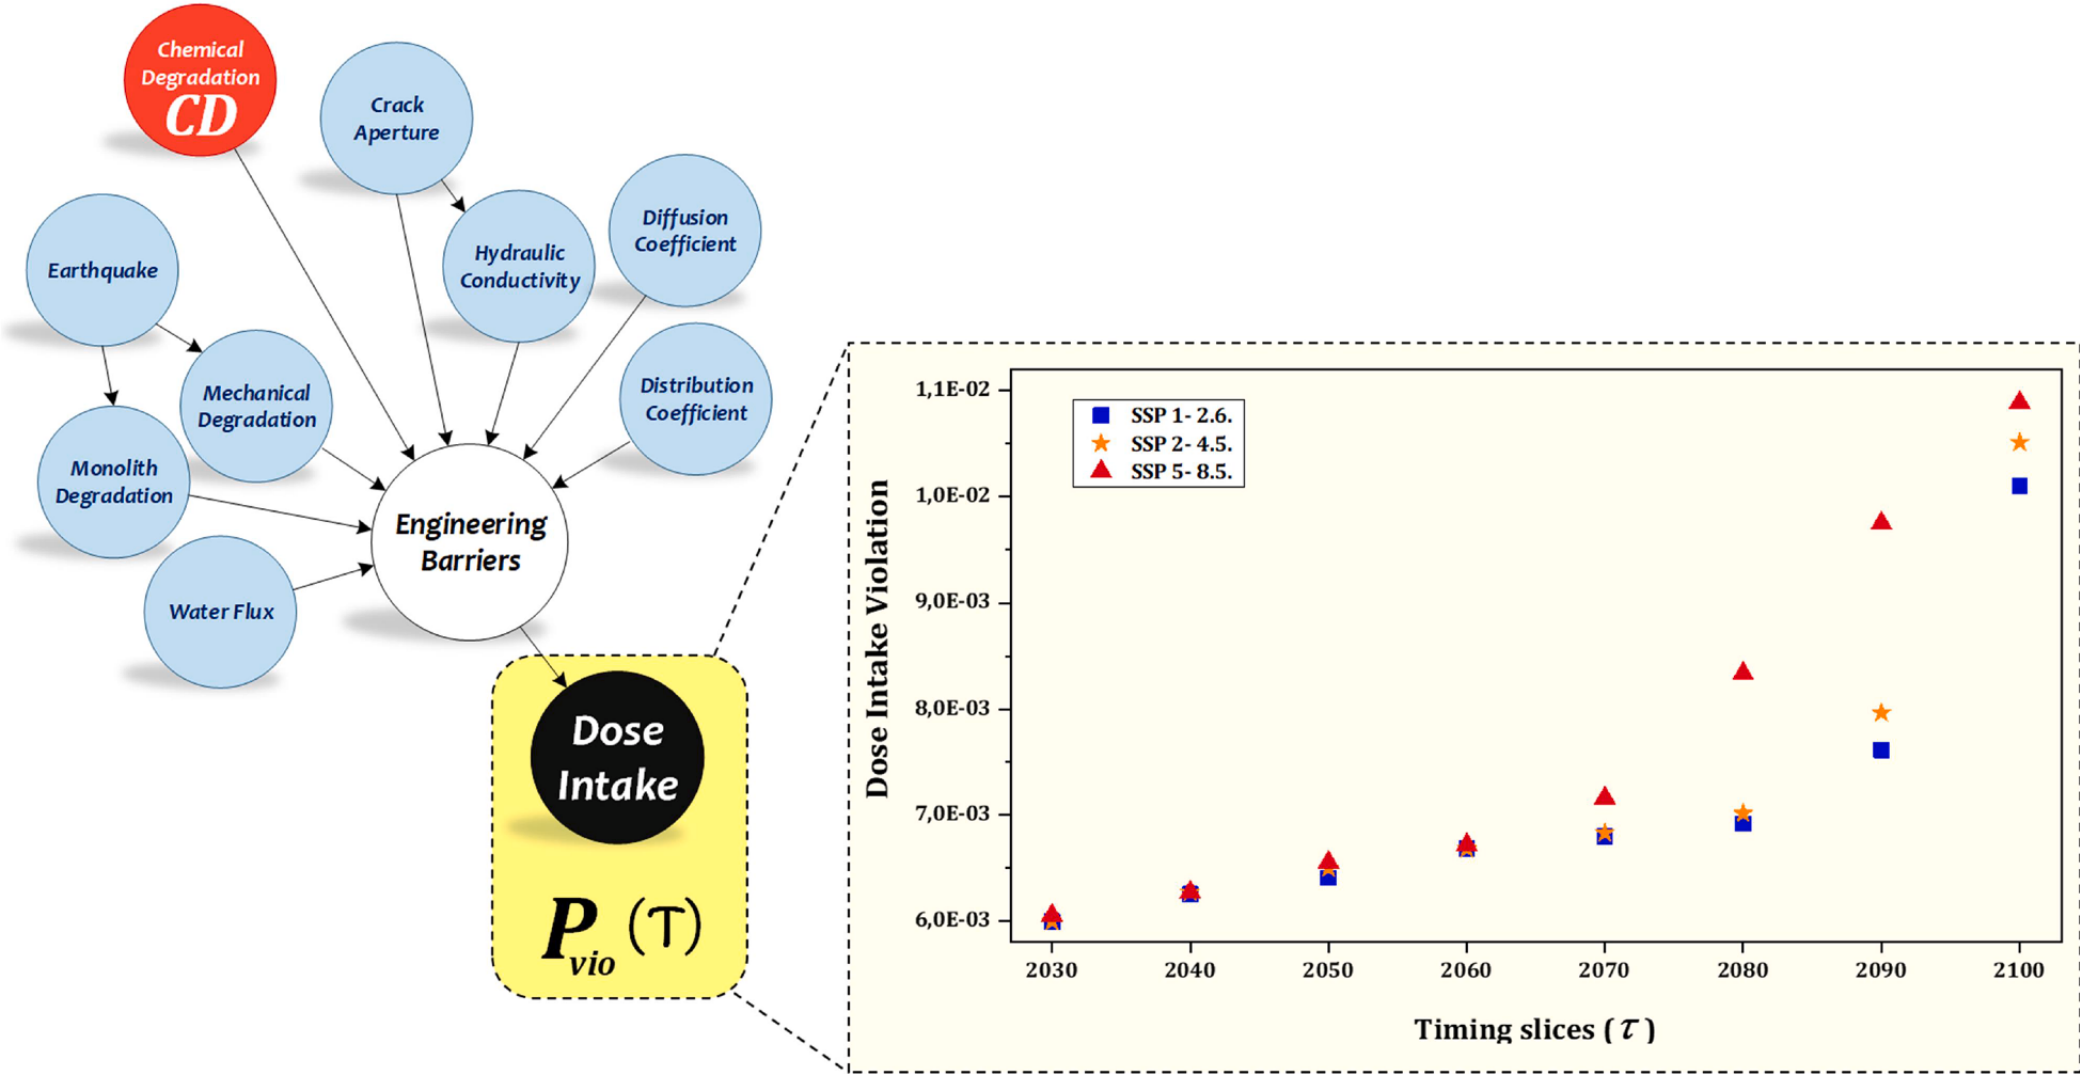
原文 Fig. 19:BN for the near-surface waste disposal and associated dose-intake violation probabilities.
Figure 19显示,不同Climate Scenarios会改变Engineering Barrier Degradation及最终Dose Intake Violation Probability。所采用的DBN能够把长期Climate Projection与Concrete Chemical Degradation和Safety Target联系起来,对不同未来情景进行概率化分析。
6.4.3. Remarkable findings
结果表明,与假设Chemical Degradation不随时间变化的情形相比,到2100年,SSP1–2.6、SSP2–4.5和SSP5–8.5对应的Dose Intake Violation Probability分别增至约1.17、1.26和1.34倍。这些变化来源于时变Chemical Degradation Process。
在严重气候变化情景SSP5–8.5下,Concrete Degradation和Dose-intake Risk最高,从2030年至2100年,Dose Intake Violation Probability增加接近两个数量级,部分退化过程比中低排放情景提前大约十年达到Critical Threshold。
研究认为,基于DBN的长期PA可以将未来Climate Change的不确定性传递到工程屏障退化和Dose Intake Risk,为核废物处置设施的长期安全决策提供依据。 但方法仍存在局限,例如DBN Structure目前由专家确定并假定固定,没有明确考虑Variables之间Causal Relationships的Structural Uncertainty。
7. Discussion
现代工业风险评估正在发生方法论变化:从Deterministic、Domain-specific Analyses转向能够反映复杂社会技术系统动态变化的Integrated、Data-driven和Adaptive Approaches。Digitalization、Interconnectivity、Cyber-physical Integration、Aging Infrastructures和Climate-induced Hazards使传统方法面临越来越多挑战,也要求风险评估能够主动、实时地识别、量化和缓解风险。
7.1. Emerging trends
本文讨论的五组研究贡献,从Flexible Production Scheduling延伸到Infrastructure Degradation、Cyber-physical Interaction、Digital Twin Monitoring和Climate-induced Risk,显示新技术与建模方法正在推动更加充分、主动的风险评估。
- Flexible manufacturing systems:TETPN–MILP Hybrid Framework表明,结合Petri网与混合整数线性规划,可以提高Energy-efficient Scheduling的计算效率和求解质量。除了提高生产率,这种方法还可以通过适应资源可用性和需求变化,降低实际运营风险。
- Aging infrastructures and degradation modeling:将PoF Model与Fragility Curve结合,可以动态考虑结构退化。对于长期服役、暴露于环境应力或Operational Wear的资产,忽略Time-dependent Deterioration可能明显低估风险。
- Cyber-physical systems and rare-event assessment:CPS越来越容易受到Low-probability、High-impact Failure影响。结合新型Importance Function的RESTART能够更有效探索Rare-event State Space,提高Risk Quantification效率并支持Mitigation Decision。
- Digital twin architectures:DT利用Simulation、Sensor和Operational Data实现实时Risk Monitoring。Grey-box Model在保持一定Explainability的同时提供自适应信息,并支持及时Control Actions、Regulatory Traceability和Operational Resilience。
- Multi-hazard, multi-layered risk assessment:将Climate Projections、Infrastructure Interdependencies与Rare-event Simulation结合的Cross-domain Framework,可用于评估Cascading Failures与Compound Hazards带来的风险。
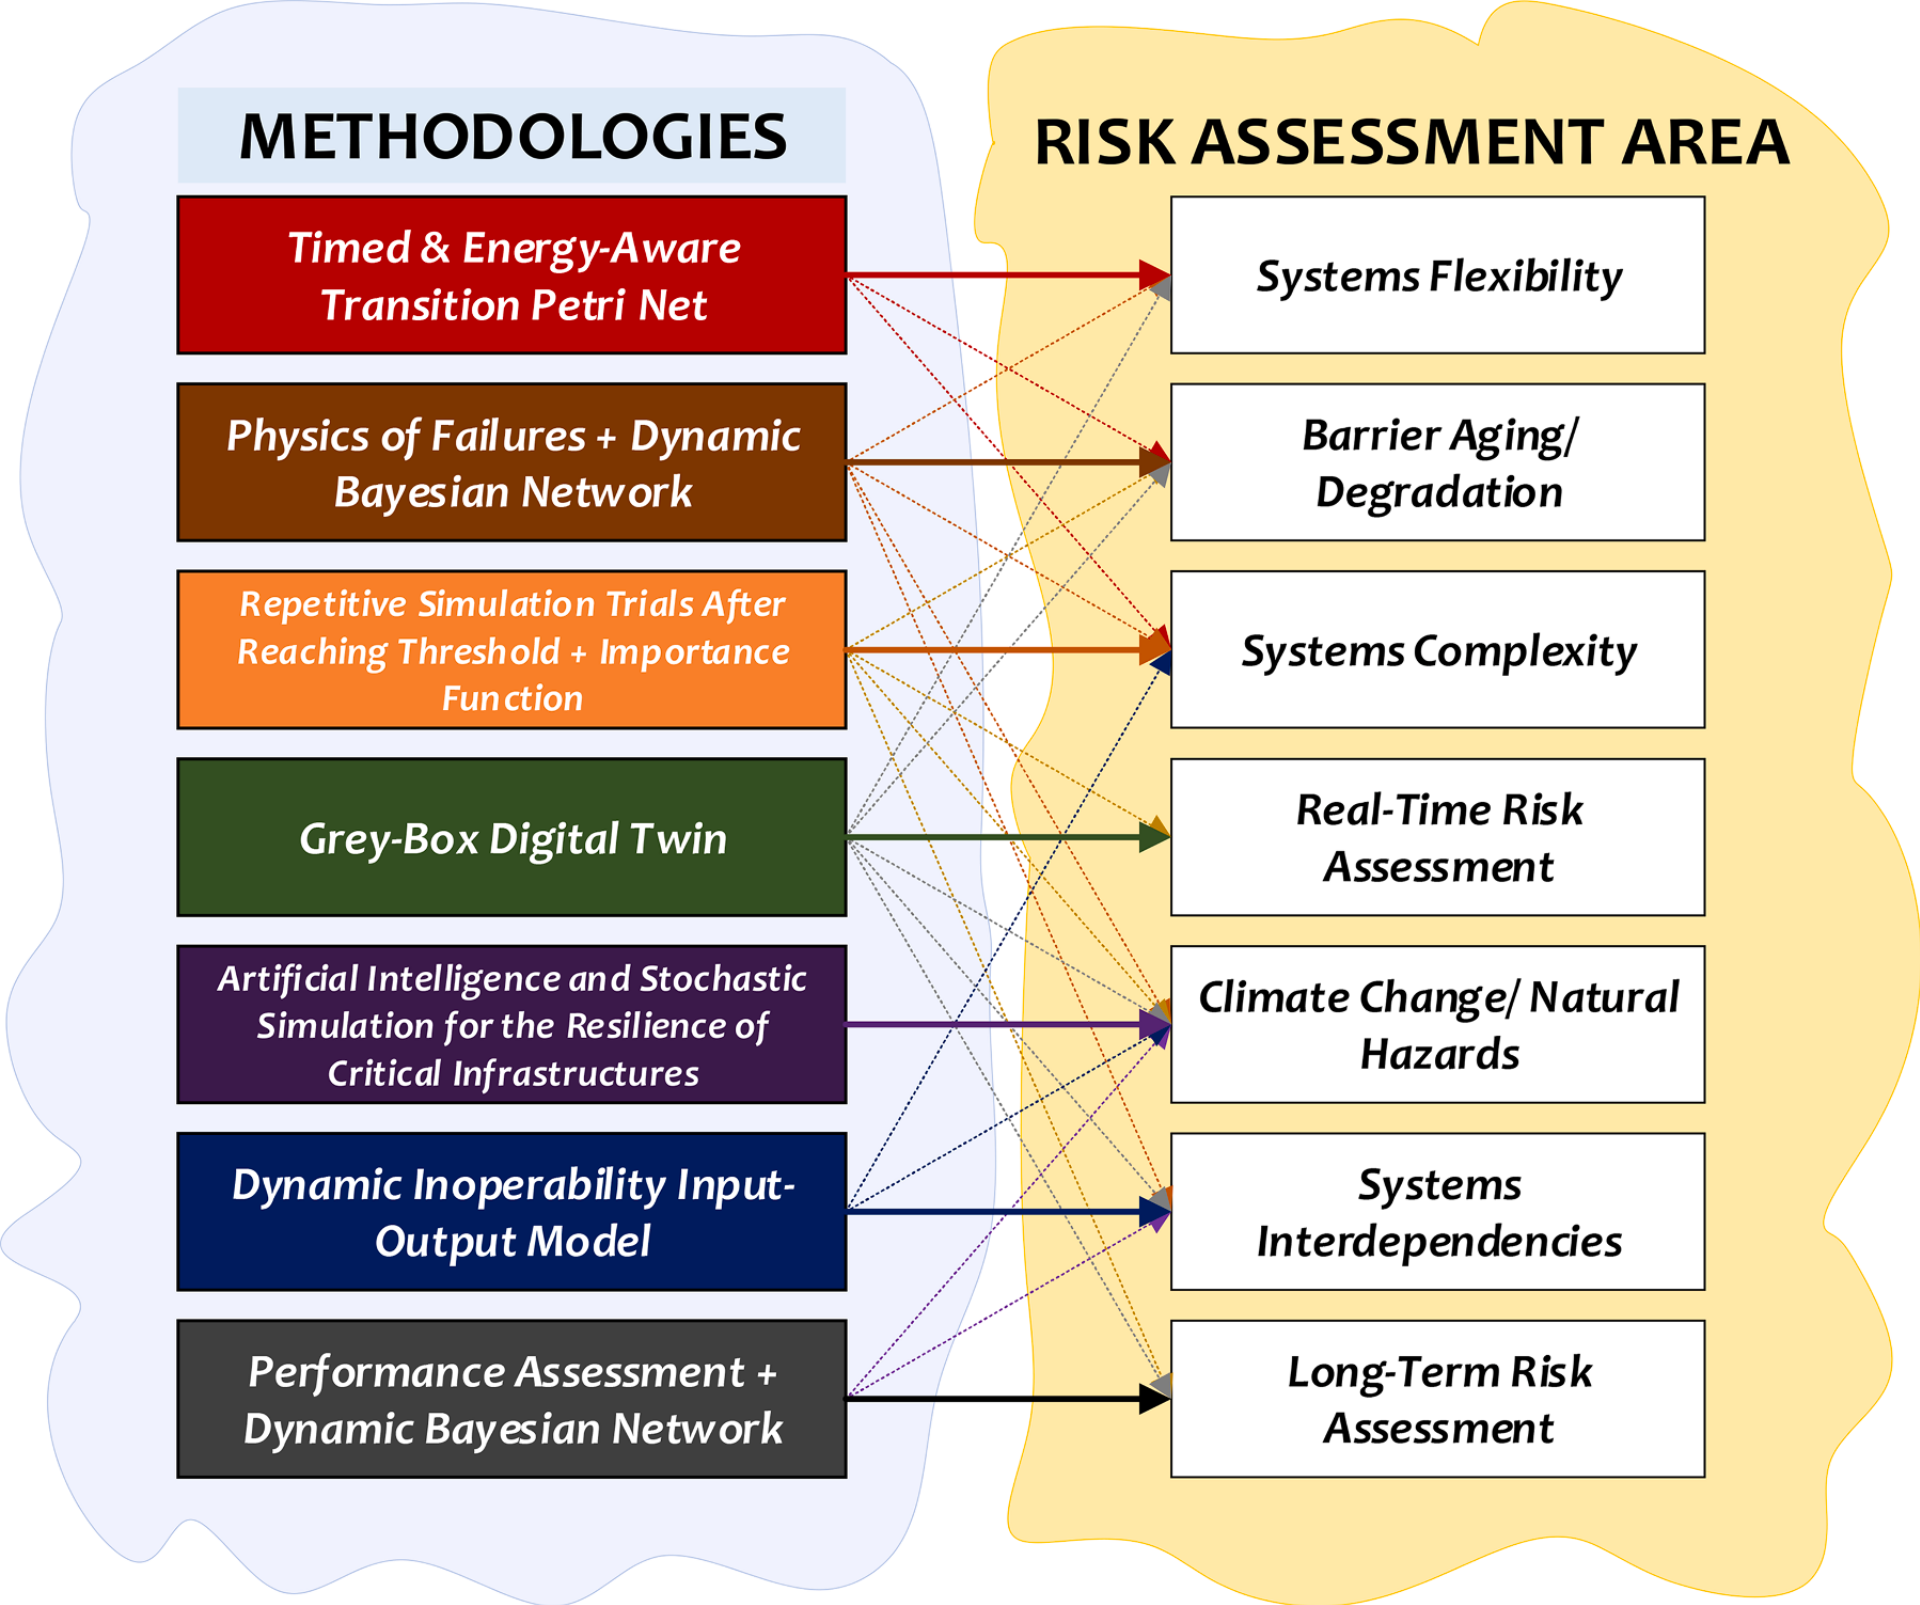
原文 Fig. 20:Presented methodologies and risk assessment characteristics in modern industry.
综合本文研究及更广泛文献,可以看到从Static、Asset-centric Analysis走向Dynamic、Adaptive和Systemic Analysis的趋势。Living PSA的发展首先体现了这种转变:监管关注点正在由批准一个固定设计,逐渐扩展到验证一个持续更新的Risk Management Process。实时数据和Adaptive Models可以使系统运行保持在预先批准的Risk Envelope内,从而在Innovation与Safety之间建立更加动态的联系。
但在Deep Uncertainty条件下应用Dynamic Risk Model,也暴露出仅仅追求单一Probability Outcome的局限。这正在推动Scenario-centric Resilience Planning的发展:通过对多个Plausible Futures进行测试,寻找Robust和Adaptive Policies。由此,分析重点从预测唯一未来转向设计能够应对多种可能结果的系统。
随着Risk Assessment扩展到SoSs,Multi-domain Risk Assessment又成为基本挑战。需要Formal Risk Ontologies和Semantic Frameworks,在不同工程领域之间标准化Risk Concept、Relationship和Metric。对于Smart Cities和Regional Infrastructures等复杂SoSs,大规模、自动化Risk Analytics需要这种Semantic Interoperability。
与此同时,Systemic、Cross-domain Perspective也使风险评估对象发生变化:不再只关注单个Asset是否安全,而是更加关注Service Continuity。Service-centric Resilience Metrics从End-user角度评价Service Disruption和Recovery Timeline,使技术风险评估与Socio-economic Consequences联系起来,从而支持更相关的Investment和Policy Decisions。
最后,在Industry 5.0原则推动下,Risk Assessment还正在超越狭义Technical Safety,将Ethical、Social和Sustainability Values纳入其中。这要求通过Multi-criteria Decision Analysis和Value-sensitive Design,让Decision-makers显式权衡Safety与Privacy、Equity及Environmental Objectives,逐渐形成更加全面的Sustainable Safety观念。
现代风险评估正在从针对单项资产的静态危险计算,发展为面向互联系统、持续服务、实时状态与长期韧性的动态决策过程。
7.2. Limitations
尽管本文介绍的方法已经在多个重要问题上取得进展,但要在真实工业环境中充分应用,仍需解决一系列开放问题。
首先是Computational Scalability。High-fidelity Simulation通常计算成本很高,尤其是在Large-scale Networks和Long-term Infrastructure Degradation Analysis中。其次是Data Availability、Governance与Interoperability。工业数据往往分散,或者由于Confidentiality及Security Restrictions无法共享,妨碍Cross-domain Validation、Reproducibility和Collaborative Model Development。Legacy Monitoring Equipment、不同数据格式与Sampling Rates也会使异构系统集成更加困难。
此外,Regulatory和Societal Requirements同样会限制实际部署。AI-driven Model和Surrogate Model通常具有Black-box特点,因此可能难以解释、审计,并且难以证明符合不断变化的监管要求。Verification、Validation和Standardized Uncertainty Reporting都很重要,但对于Learning-based和Hybrid Risk Model,目前仍不充分。
Human和Organizational Factors也经常在计算框架中没有得到足够重视。风险评估模型往往假设一种理想化的Operational Behavior,但实际Decision-making、Organizational Culture和Socio-technical Interaction可能深刻影响System Safety与Resilience。
最后,现代工业系统具有Dynamic、Multi-hazard Complexity:Physical、Cyber和Environmental Domains之间可能发生Cascading与Compound Failures。Nonlinear Interactions、Non-stationary Hazards及长期Climate-driven Uncertainty不断挑战传统建模假设。尽管现有框架已经开始描述这些Dynamics,但要在不断变化的条件下完整分析SoSs Behavior,仍然是未解决的问题。
7.3. Future directions
在前述研究基础上,未来一个重要方向是开发Integrated Hybrid Frameworks,将Physics-based、Probabilistic和AI-driven Models结合起来。这样的Hybridization能够利用Operational Data连续更新Risk Estimates,连接Predictive Simulation与Real-world Observations。把Physical Laws嵌入Machine Learning Architecture,还可能提高Model Interpretability;Reinforcement Learning和Transfer Learning则可支持系统根据不断变化的运行或环境条件自主适应。
另一个重要方向是Adaptive、Learning-based Decision Support。Reinforcement Learning、Online Optimization和Prescriptive Analytics的引入,可以把Risk Management从Reactive Process转变为Proactive Process。对于FMS和CPS等复杂系统,自适应算法能够在Uncertain和Time-varying Conditions下动态平衡Operational Efficiency、Energy Use与Safety Constraints。
未来还必须加强Cross-domain、Multi-hazard Risk Modeling,因为现代工业系统很少只面对单一Threat。把Cyber、Physical和Environmental Risks集成到统一Framework中,才能描述Cascading Failures、Compound Hazards,以及Climate Change和Infrastructure Aging造成的Slow-onset Hazards。
这类SoSs Modeling需要在Dependence Modeling、Data Fusion、Computational Efficiency和Scalability方面取得进一步进展,其中可扩展性尤其重要。Modular、Multi-fidelity和Cloud-enabled Simulation Platforms可能使对Large-scale Interconnected Systems进行High-resolution Risk Analysis成为现实。Digital Twins也是有潜力的方向,因为它们可以将Scenario-guided Simulation与Real-time Monitoring Data连接起来,支持Operational Settings下的Continuous Learning和Predictive Control。
同样重要的是建立Standardized且Trustworthy Data Frameworks。未来应重点发展Open Benchmarks、Standardized Risk Metrics、Metadata Schemes和Privacy-preserving Protocols,以保证模型能够被验证、比较,并在不同领域之间迁移。为此,Academia、Industry和Regulators需要合作,使Data Governance和Interoperability Framework与实际需要保持一致。
AI-based和Hybrid Models的发展还凸显了Explainable、Certifiable AI在Safety-critical Context中的必要性。为了获得监管机构接受和公众信任,需要建立Transparent、Auditable Models,并提供可量化的Uncertainty Bounds和Standardized Validation Procedures。
最后,真正以人为中心、以Resilience为导向的Framework还需要更深入地考虑Human Decision-making、Organizational Behavior和Ethical Principles。Risk Assessment必须从单纯Technical Exercise发展为Socio-technical Discipline,研究人员如何与Intelligent Systems交互并作出响应。长期Resilience Planning也需要进一步纳入Socio-environmental Interdependencies,不仅分析急性灾害,还要考虑随时间不断累积的Slow-onset Risks。
下一代工业风险评估框架需要把实时监测、跨域仿真、概率分析、可解释AI和人的决策过程连接起来,同时满足可扩展性、数据互操作和监管可信性的要求。
8. Conclusions
现代工业正经历前所未有的转型,其驱动力包括Digitalization、Interconnectivity、Cyber-physical Integration、Real-time Data Availability和Environmental Challenges。这些变化正在重新定义传统Risk Assessment Paradigm,要求新的模型、工具和方法能够应对High Complexity、Deep Uncertainty以及长期、多种Dynamic Hazards,例如Aging Infrastructures、Cyber-physical Interdependencies、Climate Change-induced Natural Hazards和Cascading Failures。
随着现代化系统越来越复杂、越来越容易受到Compound Hazards影响,Engineering、Data Science和Policy Frameworks的融合,对于维持Safety和Long-term Operational Resilience都变得十分关键。
本文分析了Emerging Methodologies如何在不同工业领域支持更加主动、知情且连续的Risk Assessment。通过描述Temporal Dynamics、Cross-domain Interactions和Operational Variability,这些方法能够支持Real-time Decision-making并提高System Resilience。
与此同时,研究也指出若干重要战略要求:建立Scalable Computational Platforms;建设Interoperable、Standardized Data Architectures;发展Explainable AI;将Human和Organizational Factors纳入Risk Management;并使Methodological Innovation与Regulatory Expectations、Ethical Standards协调一致,以提高技术的实际采用程度和社会信任。
面向未来,工业风险评估需要继续朝着自适应、实时、韧性驱动和兼顾伦理的方向演进,以管理多灾种风险与长期风险,支持可持续工业运行并保护公共安全。